Erstellt: 10. März 2026 • Zuletzt aktualisiert: 9. Oktober 2026
LLM-Optimization (LLMO): SEO für Sprachmodelle
Wichtigste Erkenntnisse
- LLMO fokussiert sich auf das Erlangen klickbarer Zitationen in generierten Antworten statt reiner SERP-Rankings.
- Retrieval-Augmented Generation (RAG) erfordert extrem hohe semantische Faktendichte und Answer-First-Strukturen.
- Strukturierte Entitäten-Definitionen (JSON-LD) schützen Sprachmodelle vor ungenauen Halluzinationen.
- Generischer Content wird von LLMs zusammengefasst; nur originäre Primärdaten erzwingen eine direkte Quellennennung.
Die Evolution der Suche: Vom blauen Link zum synthetisierten KI-Zitat
Die Suchmaschinenoptimierung erlebt den tiefgreifendsten Paradigmenwechsel seit der Erfindung des PageRank-Algorithmus. Über zwei Jahrzehnte hinweg konzentrierten sich Marketer darauf, Webseiten für feste Keyword-Phrasen auf Seite 1 zu platzieren, um organische Klicks abzufangen. Doch seitdem generative Sprachmodelle wie ChatGPT, Claude, Perplexity und Google AI Overviews zur primären Anlaufstelle für komplexe Fragestellungen geworden sind, greift diese lineare Mechanik zu kurz.
Nutzer erwarten heute synthetisierte Antworten, die Vor- und Nachteile abwägen, Produkte vergleichen und Handlungsempfehlungen direkt im Dialog ausgeben. In diesem Umfeld entscheidet nicht mehr die Platzierung in einer Linkliste, sondern die Frage, ob deine Marke als verlässliche Quelle zitiert wird. Hier setzt Large Language Model Optimization (LLMO) an. Es ist die technologische Disziplin, die Inhalte und Server-Architekturen so transformiert, dass Sprachmodelle deine Expertise fehlerfrei extrahieren und als unumstößliche Ground Truth in ihre Antworten integrieren.
Jörg Zimmer
Senior SEO & AI Search Consultant
„Du musst also erst mal dein SEO-Game durchspielen, um dann danach zu sagen, okay, jetzt machen wir noch den weiteren Baustein, wo wir in Richtung KI-Modelle optimieren. Aber bitte erst mal die SEO-Hausaufgaben machen.“
Jörg Zimmer auf LinkedIn folgen →
Praxis-Ampel: Large Language Model Optimization (LLMO) Roadmap
Freigabe legitimer KI-Such-Crawler (GPTBot, PerplexityBot, ClaudeBot) in der robots.txt, Bereitstellung einer sauberen llms.txt und atomare Answer-First-Absätze (BLUF) mit Schema.org Entity Grounding.
Implementierung von Markdown Content Negotiation (RFC 8288 Alternate Links). Sehr vorteilhaft für Dokumentationen und B2B-Datenblätter, erfordert jedoch Server-Routing-Anpassungen.
Pauschales Aussperren aller KI-Bots aus Angst vor Urheberrechtsverletzungen (führt zur Unsichtbarkeit in AI Chats) oder massenhafter KI-Text-Spam ohne eigene Datenbasis und ohne verifizierbare Autoren-Entitäten.
Wie Large Language Models Informationen verarbeiten
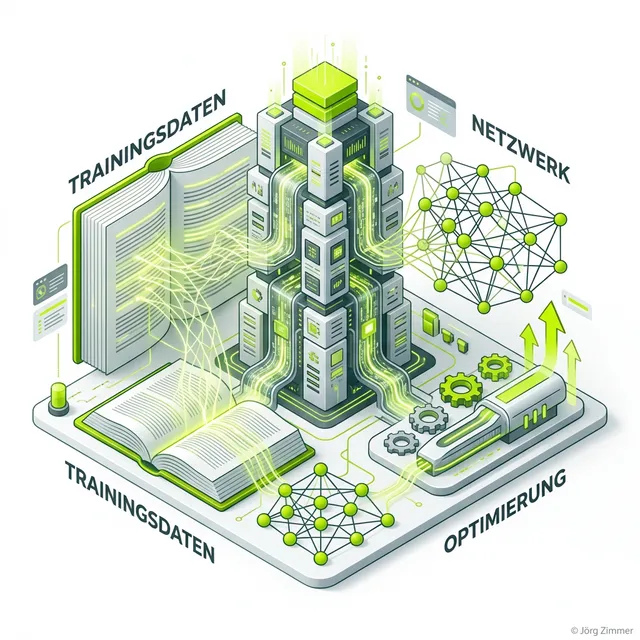
Um Inhalte für Sprachmodelle zu optimieren, muss man verstehen, wie moderne LLMs arbeiten. Ein Sprachmodell besitzt ein fixes Trainingswissen, das zu einem bestimmten Stichtag abgeschlossen wurde. Bei aktuellen, fachspezifischen oder transaktionalen Anfragen greift das Modell daher auf externe Quellen zu. Dieses Verfahren nennt sich Retrieval-Augmented Generation (RAG).
Die RAG-Pipeline läuft in vier synchronen Phasen ab:
- Query Deconstruction: Das Modell analysiert die Eingabe des Nutzers und zerlegt sie in semantische Suchvektoren.
- Web-Retrieval: Spezialisierte KI-Crawler scannen das Live-Web nach Dokumenten mit höchster Entitätsübereinstimmung.
- Semantic Chunking: Die abgerufenen Webseiten werden in kleine Textsegmente (Chunks) zerlegt und auf Relevanz geprüft.
- Synthese & Zitation: Das Sprachmodell verfasst die Antwort und setzt klickbare Fußnoten (Citations) zu den verlässlichsten Chunks.
| Dimension | Klassisches Google SEO | LLM-Optimization (LLMO) |
|---|---|---|
| Primäres Ziel | Klicks & SERP-Position 1 | Citations & Markennennung im Chat |
| Verarbeitungsmodus | Keyword-Matching & Linkgraphen | Semantische Vektoren & RAG-Chunks |
| Inhaltsformat | Ausführliche Fließtexte für Verweildauer | Kompakte Antwortblöcke nach BLUF-Prinzip |
| Format-Präferenz | HTML, CSS, JavaScript | Reines Markdown, JSON-LD, Tabellen |
| Erfolgsmetriken | Organische Klicks, CTR, Impressions | AI Share of Voice, Citation Frequency, Sentiment |
Die 4 technischen Säulen erfolgreicher LLMO
Eine tragfähige LLMO-Strategie basiert auf vier ineinandergreifenden technischen und redaktionellen Pfeilern:
1. Answer-First-Architektur (BLUF)
Sprachmodelle arbeiten mit begrenzten Kontextfenstern. Wenn eine Kernaussage in verschachtelten Marketingfloskeln versteckt ist, bricht der RAG-Parser ab. Platziere die direkte Antwort auf die Kernfrage stets in den ersten 40 bis 60 Wörtern eines Abschnitts. Erst danach folgen Erläuterungen und Details.
2. Entitäten-Definition via Schema.org
Moderne KI-Modelle navigieren nicht nach Keywords, sondern nach Entitäten. Mithilfe von präzisem Schema.org-Markup legst du maschinenlesbar fest, wer Urheber des Inhalts ist, welche Organisation dahintersteht und welche verifizierten Profile (sameAs) existieren.
3. Effiziente Datenbereitstellung via Markdown
KI-Crawler meiden rechenintensives Rendering. Indem du über Markdown Content Negotiation reines Text-Markdown auslieferst und eine strukturierte llms.txt bereitstellst, senkst du die Token-Kosten der KI-Provider und steigerst deine Zitationswahrscheinlichkeit.
4. Bereitstellung originärer Primärdaten
Austauschbare Ratgebertexte fasst die KI einfach zusammen, ohne die Quelle zu nennen. Erst wenn du eigene Umfragen, proprietary Data oder einzigartige Praxiseinblicke lieferst, zwingst du das System dazu, dich als zitierfähigen Content zu referenzieren.
Sauberes Schema-Markup und semantische Entitäten-Verankerung
Durch die saubere Verknüpfung externer Autoritätsknoten (wie Wikidata) über strukturierte Daten nach Schema.org signalisierst du Sprachmodellen ein Höchstmaß an E-E-A-T und verhinderst semantische Verwechslungen im Vektorraum.
Die 3 häufigsten Fehler bei der LLM-Optimierung
Viele Unternehmen begehen gravierende strategische Fehler, wenn sie versuchen, für Sprachmodelle sichtbar zu werden:
- Aussperren von KI-Crawlern: Wer aus Angst vor Datenübernahmen Bots wie
GPTBot,ClaudeBotoderPerplexityBotin der robots.txt blockiert, schließt sich selbst vollständig aus den Antworten der führenden KI-Systeme aus. - Floskelhafte Content-Produktion am Fließband: Das massenhafte Erzeugen generischer KI-Texte ohne eigene Faktenbasis führt zur algorithmischen Abwertung, da kein echter Information Gain vorhanden ist.
- Fehlende Grounding Pages: Wer keine dedizierte Grounding Page betreibt, auf der alle Kerninformationen, Definitionen und Leistungsmerkmale verdichtet vorliegen, überlässt die Interpretation der eigenen Marke dem Zufall.
Die Rolle von Micro-Intents und Konversations-Flows
Während klassisches SEO auf starre Suchbegriffe optimiert, erfordert LLMO ein tiefes Verständnis von sogenannten Micro-Intents. Nutzer stellen einer KI selten nur eine einzige isolierte Frage. Ein Rechercheprozess entwickelt sich über mehrere Dialogrunden (Turns): von der ersten Orientierung über detaillierte Kriterienvergleiche bis hin zur konkreten Anbieter- oder Produktauswahl.
Eine erfolgreiche LLMO-Architektur spiegelt diesen Konversationsfluss wider. Indem du strukturierte FAQ-Sektionen, tabellarische Vor- und Nachteile sowie klare Preistabellen bereitstellst, gibst du dem Sprachmodell das Rüstzeug an die Hand, um auch in nachfolgenden Konversationsschritten als bevorzugte Informationsquelle zu fungieren. So begleitest du potenzielle Kunden durch den gesamten Dialog der Answer Engine.
Monitoring und Erfolgsmessung mit spezialisierten Tools
Der Erfolg von LLMO lässt sich nicht mit klassischen Webmaster-Tools erfassen, da Nutzer in KI-Chats selten auf Links klicken. Professionelle Teams setzen daher auf spezialisierte Analyseplattformen.
Mit Rankscale überwachst du automatisiert branchenspezifische Prompts über verschiedene LLM-Engines hinweg und misst deinen prozentualen Share of Voice im Vergleich zum Wettbewerb. Wer zusätzlich klassische Rankings, Site-Audits und Backlink-Profile im Blick behalten will, nutzt das umfassende KI- und Onpage-Toolkit von SE Ranking. In Kombination mit übergeordneten Strategien der GEO Optimierung sicherst du deiner Marke die digitale Führungsrolle in der generativen Suche.
Aus der Praxis von Jörg Zimmer: Was LLMO am Montagmorgen bedeutet
Wenn Kunden in meine SEO-Sprechstunde nach Berlin-Spandau kommen und fragen: „Jörg, müssen wir jetzt unsere gesamte Website für ChatGPT umschreiben?“, lautet meine Antwort immer: Nein, aber ihr müsst aufhören, für tote Keywords zu texten und anfangen, eure Daten maschinenlesbar zu machen.
In meinen 25 Jahren als SEO – von den ersten Eigenprojekten vor über 25 Jahren über Stuttgart bis heute – hat sich eine goldene Handwerksregel nie geändert: Suchmaschinen und KI-Modelle wollen verlässliche Antworten, keine verschwurbelte Werbeprosa. LLMO ist am Montagmorgen keine Zauberei, sondern saubere technische Vorarbeit: schlanke Markdown-Bereitstellung, klare Entitäten-Relationen via Schema.org und echte, zitierfähige Primärdaten statt des nächsten generischen KI-Zusammenfassungs-Spams. Wer seine Hausaufgaben handwerklich sauber erledigt, wird von Sprachmodellen ganz automatisch als Primärquelle herangezogen.
Arbeitsanweisung für deinen KI-Agenten (Cursor / Claude / Antigravity)
Kopiere diesen Prompt direkt in deinen KI-Coding-Assistenten, um die Anforderungen automatisiert für dein Webprojekt umzusetzen:
# Prompt: LLMO & RAG-Ready Architecture Audit
Rolle: Du bist ein hochspezialisierter Technical SEO & AI Architect für Large Language Model Optimization (LLMO).
Aufgabe: Analysiere das Projekt auf RAG-Readiness, semantische Strukturierung und maschinenlesbare Datenbereitstellung für LLM-Crawler.
# Vorgehensweise & Sicherheitsregeln:
1. Tech-Stack-Analyse (Erst prüfen, dann handeln): Ermittle CMS/Framework (WordPress, Shopify, Next.js, Astro, Nuxt, Laravel, HTML), Webserver (Apache, Nginx, Vercel, Cloudflare) sowie robots.txt und HTTP-Header. Prüfe, ob KI-Crawler (GPTBot, ClaudeBot, PerplexityBot) erlaubt sind.
2. Defensive & konfliktfreie Integration: Überschreibe NIEMALS funktionierende Core-Dateien oder robots.txt-Regeln blind. Implementiere eine standardkonforme /llms.txt und bereite strukturierte Daten (JSON-LD) relational im @graph-Schema vor. Ergänze BLUF-Strukturen defensiv.
3. Standard- & URL-Hygiene: Verwende ausschließlich verifizierte Canonical Origins (https://[deine-domain.de]/) mit Trailing Slash. Stelle sicher, dass alternate Links und Markdown-Routen fehlerfreie Statuscodes (200 OK) liefern.
4. Pre-Flight-Validierung: Validiere die robots.txt-Syntax, prüfe das JSON-LD im Schema.org Validator und teste den sauberen Abruf von /llms.txt sowie die Text-Segmentierung der Answer-First-Absätze.
Output: 1. RAG-Readiness-Audit des erkannten Stacks, 2. Vorschlag für llms.txt & schema.org Ergänzungen, 3. Schritt-für-Schritt-Validierung für KI-Crawler.
Mache LLMO zum integralen Bestandteil deiner digitalen Wachstumsstrategie. Strukturiere deine Daten für RAG-Pipelines, liefere einzigartige Primärdaten und nutze Rankscale sowie SE Ranking zur kontinuierlichen Erfolgsmessung. Wer heute die Weichen für maschinenlesbare Exzellenz stellt, wird auch morgen die maßgebliche Antwortquelle sein.
LLMO & RAG in der Praxis diskutieren
Diskutiere mit Jörg Zimmer und der SEO-Community auf LinkedIn über LLM-Optimization, Prompt-Tracking und Zitationsstrategien.
Beitrag auf LinkedIn öffnenWas ist LLMO im Jahr 2026?
Was ist der Unterschied zwischen LLMO, GEO und AEO?
Wird klassisches SEO durch LLMO komplett ersetzt?
Weitere spannende Themen
- AI SEO: Mach deine Website bereit für KI-Agenten
- Common Crawl: Die wichtigste Datenbasis der KI-Welt
- llms.txt: Der Community-Standard für Crawler
- LLMs-full.txt: Die harte Wahrheit zum KI-Trend
- Grounding Page: Der Maschinen-Anker für AI SEO
- Google Algorithmus: Der Wächter der KI-Overviews
- Google Core Update: Qualitätshammer für AI
Willst du dieses Thema sauber für deine Domain umsetzen?
Ich bin Jörg Zimmer, unabhängiger Senior SEO & AI Visibility Freelancer (und Teil unseres spezialisierten Freelancer-Teams). In meiner 2-stündigen 1:1 SEO- & KI-Sprechstunde (480 € Festpreis) prüfe ich deine Website live per Screensharing auf technische Handbremsen, Schema.org-Entitäten und KI-Sichtbarkeit – direkt von mir als Senior-Experte, ohne Agentur-Overhead und ohne Vertragsbindung.