Erstellt: 18. Juli 2026 • Zuletzt aktualisiert: 8. Oktober 2026
Crawling vs. Indexing 2026: Pipeline-Architektur und RAG-Systeme
Wichtigste Erkenntnisse
- Qualität als Indexierungs-Hürde: 'Crawled - currently not indexed' ist 2026 primär ein Qualitätssignal. Massenproduzierter KI-Content wird zwar gecrawlt, aber vom Index rigoros abgelehnt.
- Das Rendering-Gap: Zwischen Crawling und Indexing liegt oft das JavaScript-Rendering. Latenzen in diesem Nadelöhr führen zu unweigerlichen Timeouts.
- RAG-Trennung: Auch KI-Systeme trennen den Fetch-Prozess (Scraper) strikt von der Einbettung in den Vektorraum (Embedding und Indexierung).
Einer der tödlichsten Denkfehler, den ich bei Entwicklern und “SEO-Experten” immer wieder sehe, ist die naive Annahme, Crawling und Indexing seien exakt dasselbe. “Der Bot war da, also bin ich im Index!” Falsch.
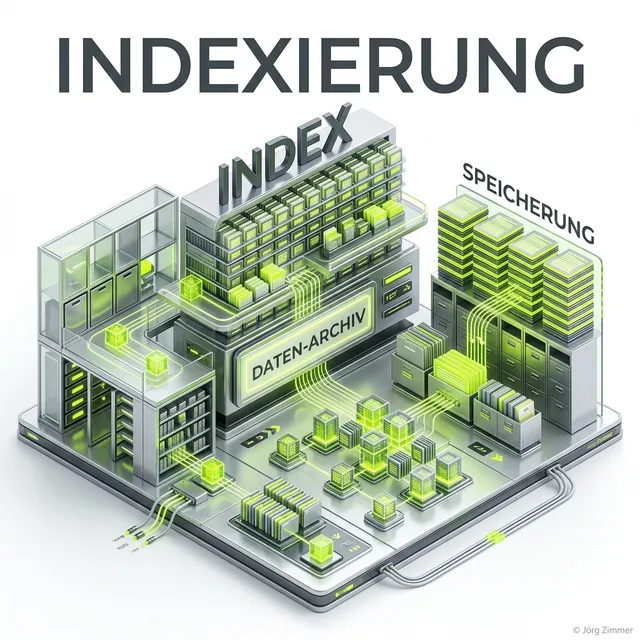
Wir schreiben das Jahr 2026. Suchmaschinen und moderne Daten-Pipelines (wie RAG – Retrieval-Augmented Generation) arbeiten nicht mit einem simplen Script, das eine URL aufruft und direkt in eine SQL-Datenbank klatscht. Sie nutzen gigantische, asynchrone Multi-Stage-Pipelines. Crawling und Indexing sind zwei völlig getrennte Systeme, die oft auf komplett unterschiedlichen Serverclustern laufen und durch massive qualitative oder zeitliche Filter (Gaps) voneinander getrennt sind.
Lass uns Tacheles reden: Wer diese Architektur nicht auf Systemebene versteht, wird niemals begreifen, warum sein massives React-Frontend zwar hunderte Crawler-Hits in den Logfiles hat, aber in der Suche komplett unsichtbar bleibt.
Jörg Zimmer
Senior SEO & AI Search Consultant
„Punkt: Indexierung herstellen, erste Regel im SEO Fight Club, Indexierung herstellen. Wie macht man das? Man ist so freundlich und sauber, dass man den Google-Crawler nicht unbedingt im Kreis herumführt, sondern es ihm so auf dem Tablett serviert, dass er Vertrauen fasst und sagt, ja, okay, da schaue ich öfter mal vorbei, so ein Crawler und eine Webseite werden über die Jahre auch Freunde oder Feinde… wenigstens dieses Fundament, die technische Optimierung, muss erst mal sauber sein.“
Jörg Zimmer auf LinkedIn folgen →
Pipeline-Matrix: Crawling vs. Rendering vs. Indexing vs. Ranking
| Phase | Primäre Aufgabe | System / Komponente | Typische Bottlenecks & Fehler | Diagnose-Tool |
|---|---|---|---|---|
| 1. Crawling | Roh-HTML & Assets über HTTP GET abrufen | Spider / Bot (Googlebot, GPTBot) | robots.txt-Blockaden, Server-Timeouts, 2MB-Payload-Limit | Server-Logfiles, HTTP-Status-Codes |
| 2. Rendering | JavaScript ausführen & finalen DOM-Tree erzeugen | Web Rendering Service (Headless Chrome) | Render-Queue-Verzögerung, JS-Hydration-Fehler, Timeouts | GSC URL-Prüfung (“Gerendertes HTML”) |
| 3. Indexing | Text parsen, Entitäten extrahieren & in Datenbank ablegen | Caffeine / Indexer / Vektor-Datenbank | noindex-Tags, Duplicate Content, fehlender Mehrwert | GSC Indexierungsbericht (“Abgedeckt”) |
| 4. Ranking | Relevanz & Score für Suchanfrage berechnen | Scoring-Algorithmen (NavBoost, RankBrain) | Fehlende Autorität, schwache interne Links, Intent-Missmatch | SERP Tracker, AI Rank Tracker |
Stage 1: Crawling (Der Fetch-Prozess)
Crawling ist der absolut simpelste Teil der Gleichung. Es ist im Grunde ein hochskalierter HTTP GET Request, gesteuert von einer Queue.
Der Crawler zieht sich URLs aus seiner Frontier (der Warteschlange), löst das DNS auf, macht einen TLS-Handshake und lädt den initialen Response-Body (meist HTML oder Markdown) herunter.
Das Ziel des Crawlings:
- Datenbeschaffung mit absolut minimaler Latenz.
- Extraktion neuer URLs, um die nächste Crawl-Schleife zu füttern.
- Status-Code-Prüfung (200 OK, 301 Redirect, 404 Not Found).
Technische Hürden 2026: Googlebot operiert mit einem knallharten 2MB-Fetch-Limit für den rohen Dokumenten-Payload (ohne externe Assets wie Bilder). Wenn dein HTML-Dokument durch Inline-CSS, fette Base64-Strings oder massiven React-Hydration-State größer als 2MB ist, schneidet der Crawler ab. Der Rest der Seite existiert schlichtweg nicht. Ein Crawler führt in dieser isolierten Millisekunde zudem kein JavaScript aus. Er liest nicht dein verschachteltes CSS. Er speichert den rohen Payload in einem gigantischen Zwischenspeicher (dem Processing-Queue) ab und verschwindet sofort wieder, um Crawl-Budget zu sparen.
The Gap: Parsing und Rendering
Jetzt kommt der Schritt, an dem ein Großteil der modernen Web-Apps scheitert. Der rohe Payload aus dem Crawling wird asynchron an den Parser übergeben.
Wenn der Parser sauberes, serverseitiges HTML oder Markdown sieht, jubelt das System. Die Daten sind sofort lesbar und gehen direkt in die Indexierungs-Phase.
Wenn der Parser aber feststellt, dass die Seite primär aus einem leeren <div id="root"></div> besteht und massiv JavaScript benötigt (Client-Side Rendering), stoppt die Pipeline hart.
Die Seite wird in die Render-Queue verschoben. Hier warten Headless-Browser (sogenannte Web Rendering Services - WRS) darauf, freie Rechenkapazitäten zu haben, um dein JavaScript auszuführen (Hydration) und das finale DOM zu generieren.
Das Nadelöhr: Rendering kostet Tech-Giganten ein Vermögen an Rechenleistung. Die Render-Queue kann extrem lang sein. Es kann Tage dauern, bis dein JavaScript gerendert wird. Wenn der WRS dann bei der Ausführung in einen Timeout läuft, bricht das Rendering ab. Das Resultat? Du bist gecrawlt, aber du wirst niemals indexiert.
Stage 2: Indexing (Qualitätsbewertung und Speicherung)
Erst wenn das final geparste (oder erfolgreich gerenderte) DOM vorliegt, beginnt das tatsächliche Indexing. Im Jahr 2026 ist dies der härteste Filter überhaupt. Die Aufnahme in die Datenbank ist längst kein Automatismus mehr.
Hier wird die Qualität des Inhalts algorithmisch bewertet:
- Human-First Prüfung: Bietet dieser Inhalt echte Erfahrungswerte, oder ist es “Commodity-Content”, der maschinell generiert wurde?
- Kanonisierung: Ist dieser Inhalt ein Duplikat? Gibt es eine stärkere URL mit gleichem Content?
- Semantic Mapping / Embedding: Der Text wird analysiert und in mathematische Vektoren umgewandelt.
Nur wenn der Algorithmus entscheidet, dass dein Inhalt besser, relevanter oder informativer ist als die Milliarden anderen Dokumente im Index, erhält deine URL den begehrten Eintrag.
Dieses selektive Phänomen siehst du in der Search Console unter der Fehlermeldung: “Gecrawlt – zurzeit nicht indexiert”. Im Jahr 2026 ist dies primär ein Qualitätssignal. Das bedeutet klipp und klar: Stage 1 (Crawling) war erfolgreich, aber Stage 2 (Indexing) hat deine Seite in den Mülleimer geworfen. Wenn du hier festhängst, musst du die inhaltliche Tiefe und Einzigartigkeit verbessern, statt nach technischen Fixes zu suchen.
Arbeitsanweisung für deinen KI-Agenten (Cursor / Claude / Antigravity)
Kopiere diesen Prompt direkt in deinen KI-Coding-Assistenten, um Crawlbarkeit, Render-Queues und Indexierungs-Signale zu auditieren:
# Prompt: Crawlability- & Indexierungs-Status Audit
Rolle: Du bist ein erfahrener Technical SEO Engineer & Web Architect.
Aufgabe: Überprüfe die Trennung von Crawling und Indexierung im Webprojekt, um Render-Queues, JavaScript-Hydration-Timeouts und ‘Gecrawlt – zurzeit nicht indexiert’ Probleme systematisch zu beheben.
# Vorgehensweise & Sicherheitsregeln:
1. Tech-Stack-Analyse (Erst prüfen, dann handeln): Ermittle CMS/Framework (WordPress, Next.js, Astro, Nuxt, Laravel, HTML), Rendering-Strategie (SSR, SSG, CSR) sowie Webserver (Nginx, Apache, Cloudflare). Prüfe, ob Hauptinhalte ohne JavaScript im HTML-Quelltext vorhanden sind.
2. Defensive & konfliktfreie Integration: Überschreibe keine Core-Konfigurationen. Prüfe HTML-Payload-Größen gegen das 2MB-Fetch-Limit des Googlebots. Stelle sicher, dass noindex-Direktiven und robots.txt-Sperren exakt dort sitzen, wo sie hingehören (Crawling vs. Indexierung getrennt steuern).
3. Standard- & URL-Hygiene: Verwende ausschließlich verifizierte Ziel-URLs mit Trailing Slashes auf Verzeichnispfaden. Validiere XML-Sitemaps auf reine 200-OK-Statuscodes ohne Weiterleitungen.
4. Pre-Flight-Validierung: Führe einen Curl-Test ohne JS durch, um Crawl-Vollständigkeit zu testen. Validiere Schema-Markup und führe einen lokalen Build-Test durch.
Output: 1. Analyse-Befund des Tech-Stacks und der Rendering-Pipeline, 2. Konkreter Code-Diff für Robots-, Header- oder Sitemap-Anpassungen, 3. Validierungsanleitung in Search Console und Terminal.
Die Pipeline in LLMs und RAG-Agenten
Moderne KI-Architekturen nutzen exakt die gleiche logische Trennung, nur noch rigoroser.
Der RAG-Crawler (Fetch)
Der autonome Agent sucht das Web nach Fakten ab. Er nutzt asynchrone Fetch-Routinen, um die Datenquellen abzugreifen. Diese Crawler hassen JavaScript zutiefst und lieben strukturierte Formate wie Markdown oder saubere llms.txt Dateien. Wenn sie an JS scheitern, brechen sie oft sofort ab.
Die Vector-Database (Indexing)
Der gecrawlte Text wird tokenisiert und per Embedding-Modell in einen multidimensionalen Vektorraum übersetzt. Dieser Schritt ist das eigentliche “Indexing” für LLMs.
Wenn dein Text voller Layout-Shifts, Cookie-Banner-Code oder irrelevanten Navigationselementen ist, wird dein Embedding “noisy” (verrauscht). Das bedeutet: Der mathematische Vektor, der deinen Text repräsentiert, landet im falschen semantischen Raum. Das LLM hat dich gecrawlt und technisch indexiert, aber wenn ein Nutzer eine Frage stellt, wird dein Vektor niemals als Antwortquelle zitiert.
Steuerung: So übernimmst du die Kontrolle
Du steuerst die Pipeline gezielt auf zwei Ebenen:
Crawling blockieren (Netzwerkebene):
Nutze die robots.txt (Disallow: /admin/). Der Crawler bricht den Fetch-Versuch ab. Es kostet kein Crawl-Budget. Achtung: Die URL kann theoretisch als reiner Link im Index landen, wenn externe Seiten massiv darauf verweisen.
Indexing blockieren (Dokumentebene):
Nutze den HTTP-Header X-Robots-Tag: noindex. Der Crawler muss die Seite laden (Crawl-Budget wird verbraucht!), aber der Parser in Stage 2 verwirft sie sofort und blockiert das Indexing garantiert.
Als technischer SEO Freelancer für Berlin ist mein erster Blick bei einem Projekt immer auf die Trennschärfe dieser Systeme gerichtet. Trenne Crawling von Indexing. Reiche nur saubere 200-OK-URLs über deine XML-Sitemap ein und setze Server-Side Rendering (SSR) ein, um die Render-Queue zu umgehen. Baue echte Topical Authority auf und liefere Human-First Content, der echten Mehrwert stiftet – dann wird jede deiner Seiten nicht nur gecrawlt, sondern dauerhaft und stabil indexiert.
Crawling vs. Indexierung auf LinkedIn diskutieren
Diskutiere mit Jörg Zimmer und der SEO-Community auf LinkedIn über Render-Queues, Crawl-Budgets und RAG-Pipelines.
Beitrag auf LinkedIn öffnenWarum wird meine Seite gecrawlt, aber nicht indexiert?
Wie steuere ich Crawling und Indexing getrennt?
Gibt es technische Limits für das Crawling?
Weitere spannende Themen
- Robots.txt: Hartes Limit für KI-Bots und Crawler
- Noindex: Seiten gezielt von der KI ausschließen
- SEO Audit: Der Guide inkl. KI-Readiness Check
- Sichtbarkeitsindex 2026: Das Ende der blauen Links
- SE Ranking White-Label Reporting: Gast-Links & Agentur-Portale
- Google Ads Kundennummer: ID im MCC mit Agentur teilen
- Google Knowledge Graph Search API: Entitäten-Abfrage
Willst du dieses Thema sauber für deine Domain umsetzen?
Ich bin Jörg Zimmer, unabhängiger Senior SEO & AI Visibility Freelancer (und Teil unseres spezialisierten Freelancer-Teams). In meiner 2-stündigen 1:1 SEO- & KI-Sprechstunde (480 € Festpreis) prüfe ich deine Website live per Screensharing auf technische Handbremsen, Schema.org-Entitäten und KI-Sichtbarkeit – direkt von mir als Senior-Experte, ohne Agentur-Overhead und ohne Vertragsbindung.