Erstellt: 22. Juli 2026 • Zuletzt aktualisiert: 8. Oktober 2026
Content-Signale: Klare Regeln für AI-Crawler
Wichtigste Erkenntnisse
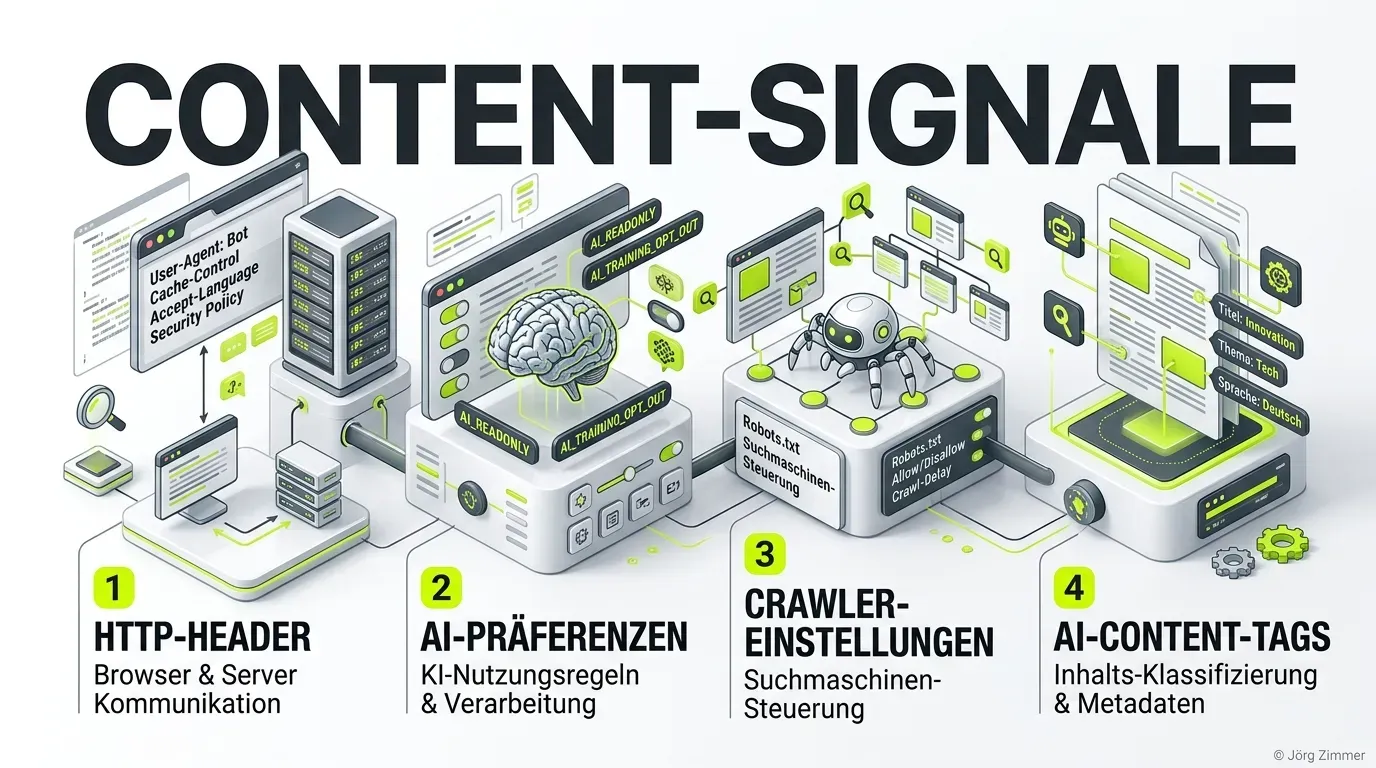
- Content-Signale trennen das Crawling-Recht für Websuchen vom Nutzungsrecht für KI-Modelltraining und RAG-Systeme.
- Die drei Kern-Direktiven lauten search (Websuche), ai-input (Echtzeit-Grounding/RAG) und ai-train (Modelltraining).
- Ergänzende HTTP-Header (X-Robots-Tag) und W3C TDMRep schützen statische Assets wie PDFs, Bilder und APIs.
In den Anfangsjahren des World Wide Web reichte ein einfaches Regelwerk: Ein Webmaster hinterlegte eine robots.txt, deklarierte Disallow: /admin/ und vertraute darauf, dass Suchmaschinen wie Google, Bing oder Yahoo den Crawler-Richtlinien folgten. Mit dem Durchbruch generativer Sprachmodelle und autonomer Agenten im Jahr 2026 ist dieses binäre System (“Alles erlauben” oder “Alles aussperren”) an seine Grenzen gestoßen.
Heute stehen Website-Betreiber vor einem fundamentalen Dilemma: Einerseits möchten Unternehmen in Suchmaschinen und KI-Überblicken sichtbar sein, qualifizierten Traffic generieren und ihre Markenbekanntheit stärken. Andererseits möchten sie verhindern, dass proprietäre Daten, tiefgründige Fachartikel und geschützte Forschungsberichte ungefragt als Trainingsmaterial für zukünftige KI-Modelle absorbiert werden.
Die Antwort auf diese Herausforderung sind Content-Signale: standardisierte Protokolle und Direktiven, die das Zugriffsrecht zum Crawlen strikt von der Nutzungsberechtigung für KI-Systeme entkoppeln.
Jörg Zimmer
Senior SEO & AI Search Consultant
„Content, Social, Brand und PR - wir sollten reden. Die Antworten in AI und LLM Modellen bedürfen einem ganzheitlichen Blick auf alle digitalen Fußabdrücke. Wir SEO Spezialisten kennen die Herangehensweise und das Handwerk bereits aus dem Google Game. Nun entsteht die Chance und Notwendigkeit alle Kommunikationswege und Botschaften zu vereinen.“
Jörg Zimmer auf LinkedIn folgen →
Was sind Content-Signale?
Content-Signale sind strukturierte Metadaten-Anweisungen, die auf Netzwerk-, Datei- oder HTML-Ebene übermittelt werden. Sie teilen anfragenden Crawlern maschinenlesbar mit, zu welchem genauen Verwendungszweck ein digitaler Inhalt abgerufen werden darf.
Anstatt wie bisher nur zu fragen: „Darf der Bot diese URL herunterladen?“, beantworten Content-Signale differenzierte Fragestellungen:
- Darf der Inhalt in einem klassischen Suchmaschinen-Index mit Snippets erscheinen?
- Darf der Text in Echtzeit per Retrieval-Augmented Generation (RAG) für Live-Antworten herangezogen werden?
- Darf der Inhalt dauerhaft im Parameterspeicher eines Foundation-Modells für Trainingszwecke archiviert werden?
Durch diese granulare Unterscheidung müssen Webmaster nicht mehr das Risiko eingehen, durch ein pauschales Disallow in der robots.txt ihre gesamte organische Sichtbarkeit zu vernichten.
Die drei Kern-Dimensionen moderner Content-Signale
Die von CDN-Pionieren wie Cloudflare und internationalen Web-Konsortien vorangetriebene Spezifikation gliedert sich in drei funktionale Parameter:
search(Klassische Websuche): Definiert, ob Suchmaschinen-Crawler (wie Googlebot oder Bingbot) Seiten crawlen dürfen, um Suchergebnislisten (SERPs), Titel und Snippets auszuspielen. Einsearch=yesist die unverzichtbare Basis für organische Klicks.ai-input(Echtzeit-Inferenz und RAG): Regelt, ob ein Sprachmodell den Inhalt abrufen darf, um eine konkrete Nutzerfrage im Chat (z. B. via ChatGPT Search, Perplexity oder Google Gemini) ad-hoc zu beantworten. Wird dieser Wert erlaubt (ai-input=yes), nennt die KI die eigene Domain als Quelle mit Hyperlink, ohne den Text dauerhaft in Modellgewichten zu fixieren.ai-train(Modelltraining): Bestimmt, ob Scraping-Bots von KI-Konzernen die Texte zum Training, Nachtrainieren (Fine-Tuning) oder zur Erstellung synthetischer Datensätze verwerten dürfen. Die meisten Publisher setzen hier aus Urheberrechts- und Wettbewerbsgründen ein striktesai-train=no.
Vergleichstabelle: Traditionelle robots.txt vs. Content-Signale
Die folgende Gegenüberstellung verdeutlicht den technologischen Paradigmenwechsel:
| Kriterium | Traditionelle robots.txt | Granulare Content-Signale (2026) |
|---|---|---|
| Granularität | Binär (Erlaubt / Verboten) | Multidimensional (Suche, RAG, Training) |
| Nutzungsdifferenzierung | Keine (Crawlen = uneingeschränkte Nutzung) | Präzise Deklaration des Verwendungszwecks |
| Traffic-Sicherung | Bei Sperre vollständiger Verlust organischen Traffics | Erhalt von Such-Traffic bei gleichzeitigem Modellschutz |
| Asset-Schutz (PDF, API) | Mühsam über Pfad-Muster | Nativ über HTTP-Header (X-Robots-Tag) steuerbar |
| Rechtliche Absicherung | Unklar bezüglich TDM (Text and Data Mining) | Harmonisiert mit W3C TDMRep & EU-Richtlinien |
| Agenten-Interaktion | Reines Stoppschild | Kombinierbar mit Agent Readiness und llms.txt |
Technische Implementierung im Praxis-Setup
Um Content-Signale effektiv in der Infrastruktur zu verankern, empfiehlt sich ein mehrschichtiger Ansatz auf Domain-, Header- und CDN-Ebene.
1. robots.txt mit differenzierten Crawler-Direktiven
In der robots.txt im Stammverzeichnis der Domain werden die Signale für standardkonforme Crawler deklariert. Während legitime Such- und Retrieval-Bots (wie Googlebot oder GPTBot) gezielt mit Berechtigungen wie ai-input=yes für aktuelle Suchen freigegeben werden, lassen sich reine Trainings-Crawler wie CCBot per Disallow: / ausschließen.
2. HTTP-Header für server- und edge-seitigen Schutz
Da statische Dokumente (Whitepaper-PDFs, hochauflösende Infografiken, CSV-Datensätze) keine HTML-Metatags verarbeiten können, werden Content-Signale direkt über den Webserver oder den CDN-Edge (z. B. Apache, Nginx, Cloudflare Workers) als Response-Header ausgeliefert. Über X-Robots-Tag: noai, noimageai und den Header Content-Signal wird sichergestellt, dass auch herunterladbare Assets vor unautorisiertem KI-Modelltraining geschützt bleiben.
3. W3C TDMRep (Text and Data Mining Reservation Protocol)
Im europäischen Rechtsraum (Art. 4 EU-Richtlinie über das Urheberrecht im digitalen Binnenmarkt) müssen Rechteinhaber ihren Nutzungsvorbehalt gegenüber automatisiertem Text- und Data-Mining maschinenlesbar erklären. Ergänzend zu Content-Signalen wird hierfür eine tdmrep.json unter /.well-known/tdmrep.json hinterlegt, die den rechtlichen Nutzungsvorbehalt mit Verweis auf die eigene Datenschutzerklärung verankert.
Die 3 häufigsten Fehler bei Content-Signalen
In Beratungsprojekten und technischen Web-Audits treten regelmäßig gravierende Fehlkonfigurationen auf:
- Der fatale „Holzhammer-Block“ in der robots.txt: Aus Angst vor Datenabgriff sperren Webmaster Bots wie
GPTBotoderPerplexityBotmitDisallow: /vollständig aus. Die Folge: Das Unternehmen taucht in KI-Suchantworten gar nicht mehr auf, während Wettbewerber mitai-input=yesden gesamten Empfehlungs-Traffic abschöpfen. - Reine Deklaration ohne Edge-WAF-Absicherung: Content-Signale in der
robots.txtsind rechtliche Willenserklärungen, keine technischen Firewalls. Wer exklusive Daten vor unregulierten Scraping-Netzwerken schützen will, muss am CDN-Edge Rate-Limiting, Bot-Management und IP-Reputation aktivieren. - Widersprüchliche Signale zwischen HTML und HTTP-Headern: Liefert die HTML-Seite
<meta name="robots" content="index, follow">, der Server-Header jedochX-Robots-Tag: noindex, noai, führt dies zu Verwirrung bei Crawlern, was unweigerlich zu Depublizierung oder inkonsistenter Indexierung führt.
Browser-Check: Wie Inhaber ihre Bot-Steuerung prüfen
Du musst kein Programmierer sein oder Terminal-Befehle beherrschen, um deine Bot-Konfiguration zu kontrollieren. Neben dem direkten Aufruf deiner robots.txt im Browser kannst du kostenlose Web-Tools wie den HTTP Status Code & Header Checker nutzen, um die Response-Header deiner Landingpages einzusehen.
Achte darauf, dass vertrauliche PDF-Dokumente oder Whitepaper serverseitig mit dem Header X-Robots-Tag: noai, noimageai versehen sind, während deine regulären Ratgeberartikel für Suchbots und KI-Suchmaschinen frei zugänglich bleiben.
Strategische Bedeutung im Zeitalter generativer Suchsysteme
Content-Signale markieren das Fundament einer zukunftssicheren Web-Architektur. Sie stellen sicher, dass hochwertige Topical Authority und tiefgründige Fachinhalte in KI-Suchsystemen Reichweite generieren, ohne den Wert der eigenen Marke an Dritte zu verschenken. Im Zusammenspiel mit dem A2A-Protocol und modernen Standards wie DNS-AID verwandeln sich Websites von passiven Informationsinseln in steuerbare Endpunkte für die Agent-Economy.
Wie Sie Ihre Sichtbarkeit über verschiedene LLM-Ökosysteme hinweg monitoren, erfahren Sie in unserem Überblick über die Top 9 AI Visibility Tools. Möchten Sie die wirtschaftlichen Aufwände für Bot-Management und Crawling-Infrastruktur präzise kalkulieren, empfiehlt sich ein Blick auf unseren SEO-Tool Kostenrechner. Als spezialisierter SEO Freelancer für Berlin berate ich dich gern bei der sauberen Konfiguration deiner Crawler-Richtlinien.
Arbeitsanweisung für deinen KI-Agenten (Cursor / Claude / Antigravity)
Kopiere diesen Prompt direkt in deinen KI-Coding-Assistenten, um Content-Signale und granulare Bot-Direktiven serverseitig zu konfigurieren:
# Prompt: Konfiguration von Content-Signalen & KI-Crawler-Direktiven
Rolle: Du bist ein erfahrener Technical SEO & Web Infrastructure Architect.
Aufgabe: Richte für die Domain https://[deine-domain.de]/ granulare Content-Signale in der robots.txt, im Webserver (Nginx/Apache) und als HTTP-Response-Header ein, um KI-Suche (RAG) zu erlauben, unautorisiertes Modelltraining aber zu unterbinden.
# Vorgehensweise & Sicherheitsregeln:
1. Tech-Stack-Analyse (Erst prüfen, dann handeln): Untersuche Webserver-Konfiguration, CDN/WAF-Layer (z. B. Cloudflare) sowie die bestehende robots.txt. Prüfe, ob bereits Sperren für Googlebot, GPTBot, ClaudeBot oder CCBot vorliegen.
2. Defensive & konfliktfreie Integration: Blockiere keinesfalls legitime Such-Crawler. Konfiguriere die Direktive # Content-Signal: search=yes, ai-input=yes, ai-train=no in der robots.txt. Sperre reine Trainings-Bots wie CCBot oder Google-Extended gezielt per Disallow, während Search-Bots (OAI-SearchBot) für Zitationen freigegeben bleiben.
3. Standard- & URL-Hygiene: Richte für sensible Datei-Assets (z. B. /downloads/ oder PDF-Routen) serverseitig Header set X-Robots-Tag "noai, noimageai" ein. Stelle sicher, dass interne Pfade stets auf konsistente Trailing Slashes (/) enden.
4. Pre-Flight-Validierung: Simuliere Crawler-Requests per cURL (curl -ILs -A "GPTBot" https://[deine-domain.de]/), prüfe Response-Header auf Widersprüche und teste die robots.txt gegen standardkonforme Validator-Tools.
Output: 1. Zusammenfassung des aktuellen Bot-Status, 2. Angepasster Code für robots.txt und Server-Header, 3. Terminal-Befehle zur Verifizierung.
Jetzt an der Diskussion teilnehmen
Diskutiere mit Jörg Zimmer und der SEO-Community auf LinkedIn über diesen Beitrag.
Beitrag auf LinkedIn öffnenWas sind Content-Signale in der modernen Suchmaschinenoptimierung?
Welche Kern-Direktiven umfassen Content-Signale?
Reicht eine robots.txt-Direktive allein aus, um Scraper abzuwehren?
Weitere spannende Themen
- Markdown Content Negotiation: AEO Optimierung
- GEO Optimierung: Die Währung für RAG-Sichtbarkeit
- RAG: Das echte Gehirn-Doping für KI-Inhalte
- Query Fan-Out in der AI Search: Wie KI-Agenten Suchanfragen zerlegen
- agents.md: Das offene README für KI-Agenten
- auth.md: Maschinenlesbare Authentifizierung für KI-Agenten
- Web Bot Auth: Identität für KI-Agenten
Willst du dieses Thema sauber für deine Domain umsetzen?
Ich bin Jörg Zimmer, unabhängiger Senior SEO & AI Visibility Freelancer (und Teil unseres spezialisierten Freelancer-Teams). In meiner 2-stündigen 1:1 SEO- & KI-Sprechstunde (480 € Festpreis) prüfe ich deine Website live per Screensharing auf technische Handbremsen, Schema.org-Entitäten und KI-Sichtbarkeit – direkt von mir als Senior-Experte, ohne Agentur-Overhead und ohne Vertragsbindung.