Erstellt: 3. August 2026 • Zuletzt aktualisiert: 8. Oktober 2026
Common Crawl: Die wichtigste Datenbasis der KI-Welt
Wichtigste Erkenntnisse
- Fundament der KI-Modelle: Der Großteil aller freien Trainingsdaten für Large Language Models wie GPT, Llama oder Claude stammt aus Archiven des Common Crawl.
- Harmonic Centrality: Die Crawl-Priorität des CCBot basiert auf graphentheoretischen Metriken wie PageRank und Harmonic Centrality im globalen Web Graph.
- Strategisches Opt-Out Dilemma: Das Blockieren des CCBot in der robots.txt schützt zwar Inhalte, tilgt eine Marke aber langfristig aus dem Weltwissen der KI.
- Qualitätsfilter C4: Rohe Crawl-Daten werden durch Pipelines wie C4 oder RefinedWeb bereinigt, weshalb sauberes semantisches Markup Pflicht für Aufnahme ist.
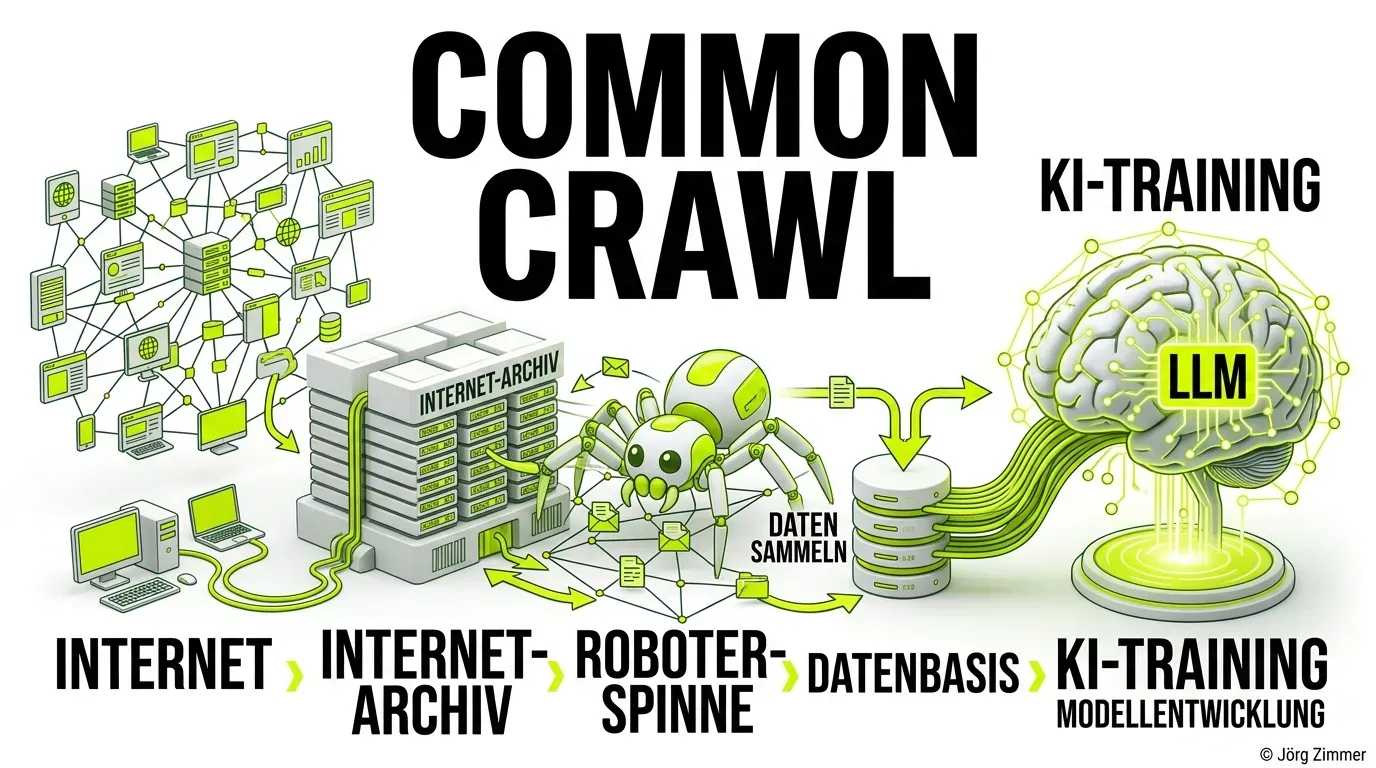
Künstliche Intelligenzen wie ChatGPT, Claude oder Gemini beantworten komplexe Fachfragen nicht ausschließlich durch Live-Recherchen im Internet. Ihr grundlegendes Faktenwissen, ihr Sprachverständnis und ihre semantischen Assoziationen entstehen während monatelanger Pretraining-Phasen auf riesigen Serverclustern. Die mit Abstand bedeutendste, frei zugängliche Rohdatenquelle für diese Trainingskorpora ist der Common Crawl.
Wer im Zeitalter von AI SEO und Generative Engine Optimization (GEO) dafür sorgen möchte, dass die eigene Marke, Produkte und Definitionen im Grundwissen führender Foundation Models verankert sind, muss die Mechanismen hinter diesem gigantischen Webarchiv verstehen. Sichtbarkeit im neuronalen Netz beginnt lange vor dem Live-Prompt des Nutzers – sie entscheidet sich bereits in den monatlichen Datensätzen des Web-Crawlers CCBot.
Jörg Zimmer
Senior SEO & AI Search Consultant
„Da ist OpenAI mit ChatGPT dabei, ByteDance aus China, TikTok, Apple, Perplexity, Amazon. Da sind wirklich die großen – das Who’s Who der AI-Crawler sind da aufgelistet. Ich könnte die alle mit einem Klick freigeben zum Trainieren meiner Daten.“
Jörg Zimmer auf LinkedIn folgen →
1. Was ist der Common Crawl und wie operiert der CCBot?
Der Common Crawl ist eine 2007 gegründete, gemeinnützige Non-Profit-Organisation mit Sitz in den USA. Ihr Ziel ist der Aufbau und die Pflege einer offenen, frei zugänglichen Kopie des weltweiten Internets. Jeden Monat durchkämmt der automatisierte Web-Crawler CCBot Milliarden von URLs, lädt HTML-Dokumente, PDFs und Metadaten herunter und speichert diese in komprimierten WARC-Dateien (Web ARChive) auf Amazon Simple Storage Service (AWS S3).
Große KI-Forschungslabore greifen auf diese Datensätze zurück, da ein eigenständiges, weltweites Crawling extrem kostenintensiv und infrastrukturell aufwendig wäre. Gefilterte Korpora wie C4 (Colossal Clean Crawled Corpus) oder RefinedWeb basieren maßgeblich auf bereinigten Common-Crawl-Dumps. Schätzungen zufolge speist sich das Basisvokabular und das Weltwissen moderner Sprachmodelle zu beträchtlichen Teilen aus diesen Archiven.
| Kriterium | Common Crawl (CCBot) | Live Search Bots (z. B. OAI-SearchBot) | Web-Archive (Wayback Machine) |
|---|---|---|---|
| Primärer Einsatzzweck | Pretraining von Basis-Sprachmodellen | Retrieval-Augmented Generation (RAG) | Historische Dokumentation & Versionierung |
| Aktualitätsintervall | Monatliche Dumps / Snapshots | Echtzeit / Sekundenschnell | Unregelmäßig nach URL-Popularität |
| Parsing-Fokus | Text-Rohdaten, DOM & Web Graph | Dynamisches HTML & aktuelle News | Vollständige visuelle Webseiten-Assets |
| Datenzugriff | Frei verfügbar für Forschung & LLMs | Proprietär innerhalb der KI-Engine | Öffentliche Weboberfläche & API |
| Relevanz für Marken | Verankerung als Entität im Foundation-Model | Berücksichtigung in aktuellen KI-Zitaten | Rechtliche Absicherung alter Stände |
Diese Strukturierung verdeutlicht die Zweiteilung moderner KI-Sichtbarkeit: Während Live-Crawler aktuelle Preisänderungen oder Produktneuheiten für Ad-hoc-Antworten erfassen, formt der Common Crawl die unerschütterliche Wissensbasis, auf die ein Modell standardmäßig zurückgreift, wenn keine Websuche getriggert wird.
2. Der Web Graph: Warum Harmonic Centrality über deinen Crawl-Status entscheidet
Der CCBot besucht nicht jede existierende Domain mit gleicher Priorität. Um die enorme Datenmenge effizient zu steuern, veröffentlicht das Projekt regelmäßig den Common Crawl Web Graph. Dieser Graph kartiert sämtliche Verlinkungen zwischen Millionen von Domains und berechnet topologische Netzwerk-Metriken.
Eine Schlüsselrolle spielt dabei die Harmonic Centrality: Sie misst, wie schnell und über wie viele Kanten eine Domain von allen anderen Knotenpunkten im gesamten Netz erreichbar ist. Domains mit einer hohen Harmonic Centrality und starker Vernetzung werden vom CCBot tiefer, häufiger und vollständiger gecrawlt.
Websites, die über ein fundiertes Backlinkprofil in vertrauenswürdigen Branchenclustern verfügen und starke thematische Topical Authority aufweisen, landen zuverlässig in den Trainingskorpora. Isolierte Nischenseiten ohne externe Verlinkung hingegen fallen den Bereinigungsfiltern der Vorverarbeitungs-Pipelines (Deduplizierung und Heuristiken) häufig zum Opfer.
3. Das Opt-Out Dilemma in der robots.txt
Mit der zunehmenden Kommerzialisierung von KI-Anwendungen ist der CCBot ins Zentrum urheberrechtlicher Auseinandersetzungen gerückt. Viele Medienverlage sperren den Bot in ihrer Konfiguration aus, um ihre redaktionellen Inhalte vor unvergütetem Training zu schützen.
Für B2B-Unternehmen, Agenturen und E-Commerce-Marken kann ein pauschales Aussperren jedoch schwerwiegende Konsequenzen nach sich ziehen: Wer den CCBot blockiert, verhindert, dass die eigenen Fachartikel, Produktkataloge und Firmenprofile in zukünftigen Sprachmodellen erlernt werden. Eine differenzierte Steuerung über die robots.txt ist daher Pflicht.
# Empfohlene Konfiguration zur kontrollierten KI-Bereitstellung
User-agent: CCBot
Allow: /
Disallow: /checkout/
Disallow: /admin/
Disallow: /intern/

# Live-Crawl-Bots für KI-Suchsysteme erlauben
User-agent: GPTBot
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# Verweis auf strukturierte Übersicht und XML-Sitemap
Sitemap: https://deinedomain.de/sitemap.xml
Über diese saubere Steuerung stellst du sicher, dass sensible Transaktions- und Verwaltungsbereiche geschützt bleiben, während dein redaktionelles Fachwissen für die Indexierung im Trainingskorpus frei zugänglich bleibt. In Ergänzung dazu bietet eine maschinenlesbare llms.txt die Möglichkeit, die wichtigsten Kernaussagen deines Unternehmens direkt an Parser zu übergeben.
4. Typische Praxisfehler im Umgang mit Common Crawl
Im technischen Alltag begegnen SEO-Spezialisten immer wieder Versäumnissen, die eine Aufnahme in die globalen Trainingskorpora sabotieren:
- Pauschale Bot-Blockaden durch Firewall-Voreinstellungen: Viele vorkonfigurierte Sicherheitsregeln in CDNs stufen den CCBot fälschlicherweise als aggressiven Scraper ein und blockieren dessen IP-Bereiche mit HTTP 403 Forbidden. Dadurch verschwindet die Domain unbemerkt aus neuen Dumps.
- Reine Client-Side-Rendering Architekturen ohne Vorverarbeitung: Da der CCBot auf maximale Effizienz getrimmt ist und Milliarden Seiten verarbeitet, führt er kein aufwendiges JavaScript-Rendering durch. Seiten, die ausschließlich auf Client-Side Rendering (CSR) setzen, liefern dem Crawler lediglich leere HTML-Gerüste. Die Umstellung auf Server-Side Rendering (SSR) oder statische Generierung ist unabdingbar.
- Mangelhafte semantische Textstruktur: Werden Texte nicht durch saubere Tags wie Überschriften, Absätze und Tabellen gegliedert, scheitern Vorverarbeitungs-Pipelines wie C4 daran, redaktionellen Inhalt von Navigationsmenüs und Bannern zu unterscheiden. Der Text wird als Rauschen verworfen.
5. Strategischer Ausblick für AI-Sichtbarkeit
Die Bedeutung von Datenaggregatoren wie Common Crawl wird in den kommenden Jahren weiter zunehmen. Sprachmodelle werden zunehmend darauf trainiert, Halluzinationen zu minimieren und Fakten präzise mit verifizierten Entitäten abzugleichen. Unternehmen müssen deshalb sicherstellen, dass ihre Markendaten, Autorensignale und Fachdefinitionen konsistent und maschinenlesbar über alle Web-Archive hinweg verfügbar sind.
Um den Aufbau deines digitalen Fußabdrucks und die Backlink-Entwicklung kontinuierlich zu überwachen, empfiehlt sich der Einsatz von SE Ranking (Partnerlink). Das Tool identifiziert Domain-Verlinkungen und hilft dir dabei, deine Harmonic Centrality gezielt zu steigern. Für die systematische Überprüfung, wie häufig und in welchen Kontexten Sprachmodelle dein Fachwissen zitieren, liefert die Analyseplattform Rankscale (Partnerlink) fundierte Einblicke in deine tatsächliche KI-Durchdringung.
Common Crawl & LLM-Trainingsdaten diskutieren
Diskutiere mit Jörg Zimmer und der SEO-Community auf LinkedIn über CCBot, Trainingskorpora wie C4 und strategische Sichtbarkeit in Foundation Models.
Beitrag auf LinkedIn öffnenWas ist der Common Crawl genau?
Sollte ein kommerzielles Unternehmen den CCBot aussperren?
Wie unterscheidet sich der Common Crawl von Live-Web-Crawlern?
Wie oft besucht der CCBot eine Website?
Weitere spannende Themen
- llms.txt: Der Community-Standard für Crawler
- LLMs-full.txt: Die harte Wahrheit zum KI-Trend
- Grounding Page: Der Maschinen-Anker für AI SEO
- Google Algorithmus: Der Wächter der KI-Overviews
- Google Core Update: Qualitätshammer für AI
- Google AI Overviews: Funktionsweise, Zitierung & SEO (2026)
- KI-Content: Die Wahrheit über Google und KI-Texte
ℹ️ Transparenz-Hinweis zu Partnerlinks
Einige Links in diesem Beitrag sind sogenannte Partnerlinks (mit einem Sternchen * oder als solche gekennzeichnet). Wenn du über einen dieser Links ein Tool buchst oder testest, erhalte ich gegebenenfalls eine kleine Provision. Der Preis für dich bleibt exakt derselbe – du unterstützt damit meine unabhängigen Tests und Praxisberichte.
Willst du dieses Thema sauber für deine Domain umsetzen?
Ich bin Jörg Zimmer, unabhängiger Senior SEO & AI Visibility Freelancer (und Teil unseres spezialisierten Freelancer-Teams). In meiner 2-stündigen 1:1 SEO- & KI-Sprechstunde (480 € Festpreis) prüfe ich deine Website live per Screensharing auf technische Handbremsen, Schema.org-Entitäten und KI-Sichtbarkeit – direkt von mir als Senior-Experte, ohne Agentur-Overhead und ohne Vertragsbindung.