Erstellt: 4. Oktober 2026 • Zuletzt aktualisiert: 20. Oktober 2026
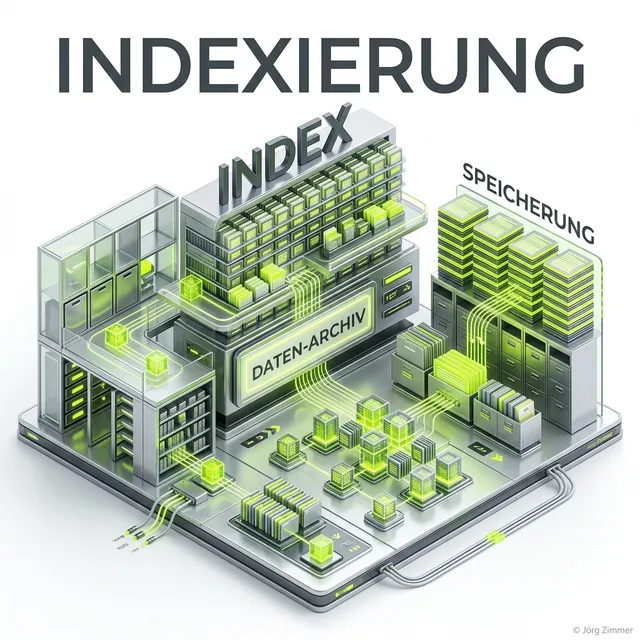
Indexierung: Wie Suchmaschinen Webseiten speichern & werten
Wichtigste Erkenntnisse
- Die erste Regel im SEO Fight Club lautet: Indexierung herstellen! Ohne Aufnahme in den Suchindex gibt es weder Rankings noch KI-Zitate.
- Besuch ist nicht gleich Aufnahme: 'Gecrawlt – zurzeit nicht indexiert' heißt im Klartext, dass Google deine Seite gelesen, aber wegen zu geringem Mehrwert oder schwacher Verlinkung aussortiert hat.
- Erst ab dem Tag der Indexierung läuft die 13-Monats-Uhr für deine Nutzersignale (CrUX/Chrome) an – jeder Monat außerhalb des Index ist verlorene Reifezeit.
- Auch die Google Indexing API oder IndexNow beschleunigen nur den Bot-Besuch (Crawling), ersetzen aber niemals den inhaltlichen Qualitäts-Türsteher.
Wenn mich jemand fragt, womit Suchmaschinenoptimierung in der Praxis anfängt, lautet meine Antwort seit über zwei Jahrzehnten gleich: Die erste Regel im SEO Fight Club heißt: Indexierung herstellen!
Das klingt für viele erst mal banal. Fast jeder Geschäftsführer oder Marketing-Leiter, der zu mir in die Beratung kommt, geht selbstverständlich davon aus, dass alle seine mühsam geschriebenen Unterseiten auch bei Google im System liegen. Wenn wir dann aber gemeinsam in die Google Search Console schauen und den Bericht „Seiten“ aufklappen, fällt den meisten die Kinnlade herunter: Oft liegt die Hälfte des Blogs, ein Drittel der Kategorieseiten oder sogar eine wichtige Leistungsseite in der grauen Tonne unter „Nicht indexiert“. Und eine Unter-URL, die nicht im Index steht, ist für Google, Bing und sämtliche KI-Suchmaschinen schlichtweg unsichtbar – sie kann keinen einzigen Besucher und keinen einzigen Euro Umsatz bringen.
Jörg Zimmer
Senior SEO & AI Search Consultant
„SEO fängt an bei: Ich werde erst mal indexiert. Das heißt, du musst erst mal sicherstellen, dass alle deine Seiten so im Index sind, wie du es haben möchtest… es ist ein hervorragender Überblick, wie gesund ist deine Seite: gecrawlt, zurzeit nicht indexiert, und gefunden, zurzeit nicht indexiert.“
Jörg Zimmer auf LinkedIn folgen →
Praxis-Ampel: Wie gesund ist die Indexierung deiner Domain?
Alle geldwerten Leistungs-, Kategorie- und Fachseiten stehen in der Search Console auf „Indexiert“. In der XML-Sitemap liegen ausschließlich echte 200 OK-URLs mit sauberem Trailing Slash.
Wichtige Unterseiten hängen wochenlang in „Gefunden – zurzeit nicht indexiert“ oder „Gecrawlt – zurzeit nicht indexiert“. Der Seite fehlen interne Links aus starken Artikeln und echter Informationsgewinn.
Vergessene noindex-Haken aus der Entwicklungsphase, widersprüchliche Canonical Tags oder tausende Parameter- und Filter-URLs, die dein Crawl-Budget komplett auffressen.
Die 4 Stufen der Suchmaschinen-Pipeline (Warum Besuch nicht gleich Einlass ist)
Um zu verstehen, warum Google oder Bing eine Seite nicht aufnehmen, musst du den Unterschied zwischen Crawling und Indexing kennen. Viele werfen beides in einen Topf, aber technisch sind das vier streng getrennte Stationen:
| Phase | Was im Maschinenraum passiert | Typische Stolpersteine in der Praxis |
|---|---|---|
| 1. Discovery (Entdeckung) | Der Bot erfährt überhaupt erst, dass deine URL existiert – über deine XML-Sitemap oder über einen Link im Spinnennetz deiner internen Verlinkung. | Verwaiste Seiten (Orphan Pages), auf die kein einziger interner Link zeigt. |
| 2. Crawling (Abruf) | Der Crawler klopft am Server an und lädt den rohen HTML-Quelltext herunter. | Sperren in der robots.txt, lahme Server-Antwortzeiten oder kaputte HTTP-Statuscodes (5xx). |
| 3. Rendering (Ausführung) | Ein Headless-Browser führt dein JavaScript aus, um zu sehen, was nach dem Laden wirklich auf der Seite steht. | Schweres Client-Side-JavaScript (Two-Wave Indexing), bei dem der Bot zuerst nur eine leere Hülle sieht. |
| 4. Indexierung (Aufnahme) | Erst jetzt prüft der Qualitäts-Türsteher den Inhalt, zerlegt ihn in Wörter, Entitäten und Vektoren und speichert ihn im Suchindex ab. | Vergessenes Noindex-Tag, falsches Canonical Tag oder schlichtweg zu dünner Standard-Text. |
Merke dir diese Faustregel: Crawling ist nur die Einladung zur Party. Indexierung ist die Entscheidung des Türstehers, ob du auch wirklich in den Club reinkommst.
Jörg Zimmer
Senior SEO & AI Search Consultant
„Ich hatte mal die Frage was man denn überhaupt mit der Google Search Console machen könnte. Eine Sache ist dort wirklich einfach und auch visuell zu sehen. Wie viele Seiten Google überhaupt von dir im Index hat. Das ist bei vielen Projekten weniger als alle immer glauben. Die erste Regel im SEO Fighclub: Indexierung herstellen!“
Warum jede Woche ohne Indexierung deine 13-Monats-Uhr aufhält
Warum reite ich in meinen Audits so gnadenlos darauf herum, dass neue Leistungs- und Fachseiten sofort in den Index müssen? Wegen der 13-Monats-Uhr für Nutzersignale!
Wie wir aus dem großen Google-Leak wissen, sammelt Google über den Chrome-Browser (CrUX-Daten) bis zu 13 Monate lang historische Nutzersignale auf jeder einzelnen Unter-URL – 13 Monate deshalb, weil bewegliche Feiertage wie Ostern oder Pfingsten jedes Jahr in einem anderen Monat liegen und Google einen echten Jahresvergleich braucht. Solange deine Unterseite nicht indexiert ist, kann kein einziger Nutzer über die Suche auf ihr landen. Die Uhr steht still. Erst an dem Tag, an dem die URL im Index steht und erste Impressionen sammelt, fängt deine Seite an, sich aus der „Babyphase“ herauszuarbeiten.
Die 5 häufigsten Meldungen in der Search Console – übersetzt in Klartext
Wenn du in der Search Console unter „Seiten -> Warum Seiten nicht indexiert werden“ nachschaust, wirft dir Google fünf Klassiker vor die Füße. So übersetze ich sie meinen Kunden im Gespräch:
1. „Gecrawlt – zurzeit nicht indexiert“ (Der Qualitäts-Korb)
Das ist heute das mit Abstand häufigste Sorgenkind. Der Googlebot war auf deiner Seite, hat den HTML-Code komplett gelesen und sagt dann: „Danke, aber diesen Text habe ich so ähnlich schon zehntausendmal im Internet gesehen – dafür verschwende ich keinen Platz in meinem Index.“ Wie wir das lösen: Nicht durch zehnfaches Klicken auf „Indexierung beantragen“, sondern indem wir der Seite echte Persönlichkeit, eigene Praxiserfahrungen (Information Gain) und vor allem 5 bis 7 kräftige interne Links von deinen bereits gut rankenden Seiten spendieren.
2. „Gefunden – zurzeit nicht indexiert“ (Der Stau vor der Tür)
Google kennt die Adresse zwar aus deiner Sitemap, hatte aber noch keine Lust, den Bot überhaupt vorbeizuschicken. Das passiert oft bei ganz frischen Domains oder wenn dein Crawl-Budget durch tausende unnütze Filter-URLs verstopft ist.
3. „Durch ‚noindex‘-Tag ausgeschlossen“ (Der Klassiker nach dem Relaunch)
Ich erzähle dazu im Podcast gern die Geschichte von der Schule meiner beiden Töchter: Die Schule hatte eine schicke neue Website bekommen, aber man fand sie monatelang nicht bei Google – nicht einmal, wenn man exakt nach dem Namen der Schule gesucht hat! Als ich in den Quellcode geschaut habe, war das Rätsel in zehn Sekunden gelöst: Die Entwickler hatten während der Bauphase in WordPress den kleinen Haken „Suchmaschinen davon abhalten, diese Website zu indexieren“ gesetzt und beim Livegang schlichtweg vergessen, ihn wieder rauszunehmen. Ein einziger Klick – und drei Tage später war die Schule auf Platz 1.
4. „Duplikat – vom Nutzer nicht als kanonisch festgelegt“
Deine Seite ist unter mehreren Adressen erreichbar (zum Beispiel mit und ohne Trailing Slash oder mit Tracking-Parametern), und du hast Google über das Canonical Tag nicht klar gesagt, welche Version das Original ist. Also würfelt Google selbst.
5. „Soft 404“
Dein Server meldet technisch zwar 200 OK („Alles super!“), aber auf der Seite steht nur ein Satz wie „Keine Produkte gefunden“ oder der Text wurde radikal zusammengestrichen. Google merkt den Widerspruch und wirft die URL als Soft 404 aus dem Index.
Warum auch die Google Indexing API kein Freifahrtschein ist
In vielen Foren kursiert der Tipp: „Installier dir einfach ein Skript für die Google Indexing API, dann ist jede Seite in zwei Stunden indexiert!“ Vorsicht vor diesem Halbwissen:
- Offizielle Einschränkung: Google erlaubt die Nutzung der Indexing API offiziell ausschließlich für Seiten mit
JobPosting(Stellenanzeigen) oderBroadcastEvent(Live-Streams), weil diese Daten extrem schnell veralten. - Ping ersetzt keine Qualität: Selbst wenn du über die Search Console manuell auf „Indexierung beantragen“ klickst oder für Bing und ChatGPT das offizielle IndexNow-Protokoll nutzt, holst du damit nur den Crawler schneller an die Tür. Wenn der Inhalt auf der Seite dünne KI-Massenware ohne eigene Substanz ist, wird die URL zwar gecrawlt, landet aber am nächsten Tag sofort wieder unter „Gecrawlt – zurzeit nicht indexiert“.
Invertierter Index vs. Vektorraum: Wie Google & KI heute speichern
Unter der Haube speichert eine moderne Suchmaschine deine Seite heute gleich doppelt ab:
| Merkmal | Klassischer invertierter Index (Wort-Index) | Semantischer Vektorraum (KI & RAG) |
|---|---|---|
| Wie gespeichert wird | Wie das Stichwortverzeichnis hinten im Fachbuch: Wort → Liste aller URLs, auf denen es steht. | Texte werden in mathematische Zahlenreihen (Vektoren) übersetzt, die die Bedeutung abbilden. |
| Was abgeglichen wird | Steht das gesuchte Keyword in der H1, im Title und im Text (BM25-Gewichtung)? | Passt dein Textblock inhaltlich zur Frage des Nutzers, selbst wenn andere Wörter benutzt werden? |
| Was der Bot braucht | Sauberes HTML, schnelle Core Web Vitals, klare Überschriften. | Klare Fakten-Absätze, strukturierte Daten (JSON-LD) und eindeutige Entitäten. |
Arbeitsanweisung für deinen KI-Agenten (Cursor / Claude / Antigravity)
Kopiere diesen Prompt direkt in deinen KI-Coding-Assistenten, um den Indexierungs-Status deiner wichtigsten Seiten automatisiert zu prüfen und Blocker zu beseitigen:
# Prompt: Technischer Indexierungs-Audit & Inlink-Stärkung
Rolle: Du bist ein hochspezialisierter Technical SEO & Web Architect.
Aufgabe: Prüfe die geschäftskritischen URLs von https://[deine-domain.de]/ auf technische Indexierungs-Barrieren (Noindex, Canonical-Abweichung, HTTP-Status, Sitemap-Hygiene) und stärke Seiten mit dem Status „Gecrawlt – zurzeit nicht indexiert“.
# Vorgehensweise & Sicherheitsregeln:
1. Tech-Stack-Analyse (Erst prüfen, dann handeln): Ermittle CMS/Framework (WordPress, Shopify, Next.js, Astro, Nuxt, Laravel, HTML), Webserver (Apache, Nginx, Vercel, Cloudflare) sowie Rendering-Methode (SSR, SSG, CSR). Prüfe, ob der Hauptinhalt direkt im initialen HTML-Quelltext ohne JavaScript-Ausführung sichtbar ist.
2. Defensive & konfliktfreie Integration: Überschreibe NIEMALS funktionierende Core-Routen. Stelle sicher, dass noindex-Direktiven (im HTML-Meta-Tag und im HTTP-Header X-Robots-Tag) ausschließlich auf administrativen Seiten greifen.
3. Standard- & URL-Hygiene: Alle internen Links, Sitemap-Einträge und Canonical Tags müssen exakt dieselbe URL-Schreibweise (HTTPS + konsistenter Trailing Slash) verwenden. Ermittle für jede nicht indexierte Zielseite mindestens 5 thematisch passende, bereits stark verlinkte Artikel und füge dort kontextuelle In-Text-Links ein.
4. Pre-Flight-Validierung: Verifiziere per curl -I die HTTP-Header (Status 200 OK, kein 301-Hop in der Sitemap) und führe einen lokalen Build-Test durch.
Output: 1. Diagnose-Tabelle der geprüften URLs, 2. Konkreter Code-Diff für Technik-Fixes und neue interne In-Text-Links, 3. Prüfliste für den Live-URL-Test in der Google Search Console.
Mein 4-Schritte-Rezept, wenn eine wichtige Unterseite nicht in den Index will
Wenn wir in meiner 2-stündigen SEO-Sprechstunde sehen, dass eine deiner wichtigsten Seiten in „Gecrawlt – zurzeit nicht indexiert“ feststeckt, gehen wir exakt diese vier Schritte durch:
- Live-URL-Test in der Search Console: Wir prüfen live, ob Google die Seite technisch abrufen kann, ob das selbstreferenzierende Canonical Tag stimmt und ob im gerenderten HTML wirklich der gesamte Text ankommt.
- Spinnennetz enger knüpfen (5 bis 7 echte Inlinks): Wir lassen die Seite nicht als einsame Insel stehen. Wir suchen 5 bis 7 deiner stärksten, bereits indexierten Artikel heraus und setzen von dort aus saubere In-Text-Links mit passendem Ankertext direkt auf das Sorgenkind.
- Echten Praxis-Mehrwert nachlegen: Wir werfen generisches Lexikon-Blabla raus und reichern die Seite mit deiner echten Erfahrung, konkreten Kundenbeispielen, Vergleichstabellen und einem strukturierten FAQ-Markup an.
- Neu-Indexierung anstoßen: Erst wenn der neue Inhalt und die neuen internen Links live sind, klicken wir in der Search Console bei der geänderten Zielseite (und bei 2–3 der verlinkenden Quellseiten!) auf „Indexierung beantragen“. In 90 Prozent der Fälle ist die Seite wenige Tage später dauerhaft grün.
Jetzt an der Diskussion teilnehmen
Diskutiere mit Jörg Zimmer und der SEO-Community auf LinkedIn über diesen Beitrag.
Beitrag auf LinkedIn öffnenWas ist der genaue Unterschied zwischen Crawling und Indexierung?
Was heißt 'Gecrawlt – zurzeit nicht indexiert' in der Google Search Console wirklich?
Hilft die Google Indexing API gegen 'Gecrawlt – zurzeit nicht indexiert'?
Wie prüfe ich am schnellsten, wie viele meiner Seiten wirklich im Index sind?
Weitere spannende Themen
- Canonical Tag: Schluss mit Duplicate Content
- Hreflang im SEO: Internationalisierung ohne Duplicate Content
- 404 Fehlerseiten: Wie sie KI-SEO zerstören
- Soft-404-Fehler: Definition, Ursachen & Behebung im SEO
- Orphan Pages: Definition, Gefahren und Behebung im SEO
- Crawl-Budget: Definition, Verschwendungsfallen & Hebel im SEO
- AI Crawlability: Maschinenlesbarkeit für Answer Engines
Willst du dieses Thema sauber für deine Domain umsetzen?
Ich bin Jörg Zimmer, unabhängiger Senior SEO & AI Visibility Freelancer (und Teil unseres spezialisierten Freelancer-Teams). In meiner 2-stündigen 1:1 SEO- & KI-Sprechstunde (480 € Festpreis) prüfe ich deine Website live per Screensharing auf technische Handbremsen, Schema.org-Entitäten und KI-Sichtbarkeit – direkt von mir als Senior-Experte, ohne Agentur-Overhead und ohne Vertragsbindung.