Erstellt: 3. August 2026 • Zuletzt aktualisiert: 8. Oktober 2026
Web Application Firewall (WAF): Schutz vs. SEO
Wichtigste Erkenntnisse
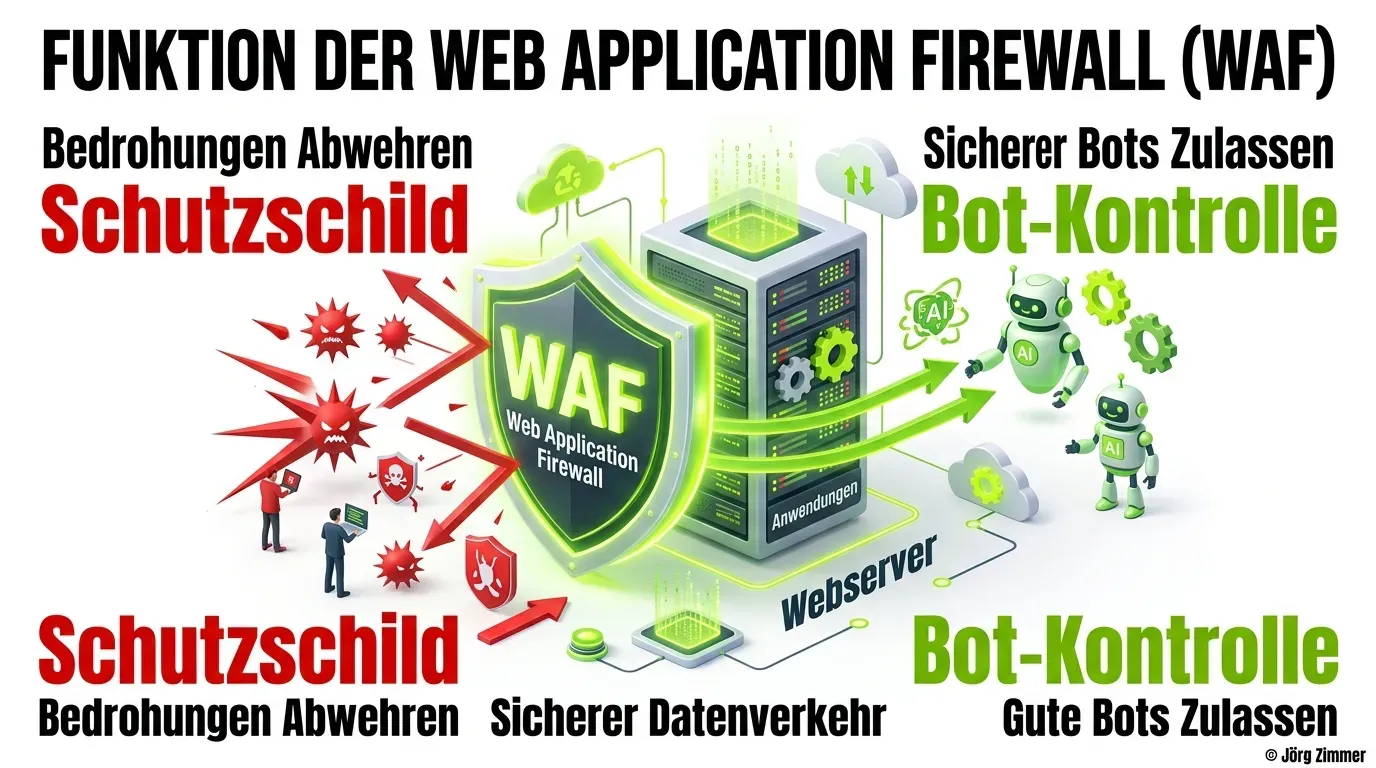
- Schutzschild mit Nebenwirkungen: Eine WAF schützt vor Cyberangriffen, blockiert bei fehlerhafter Konfiguration jedoch legitime Suchmaschinen und KI-Agenten.
- Granulares Bot-Handling: Strikte Unterscheidung zwischen schädlichen Scrapern, reinen AI-Trainingsbots und wertvollen Live-Search-Agenten sichert Reichweite.
- Verified Bots Bypass: Legitime Crawler von Google, Bing und OpenAI müssen in der Regelführung stets vor allgemeinen Sicherheits-Challenges freigegeben werden.
- Monitoring von Statuscodes: Regelmäßige Audits der WAF-Logs auf Statuscodes wie 403 Forbidden verhindern plötzliche Indexierungsabbrüche.
Sicherheit und Auffindbarkeit stehen im modernen Webdesign in einem permanenten Spannungsverhältnis. Auf der einen Seite sehen sich Website-Betreiber einer Flut automatisierter Angriffe, bösartiger Scraper und ressourcenhungriger Bots ausgesetzt. Auf der anderen Seite ist die organische Reichweite darauf angewiesen, dass Suchmaschinen-Crawler und generative KI-Agenten uneingeschränkten und schnellen Zugriff auf alle relevanten Inhalte erhalten. Im Zentrum dieses Konflikts steht die Web Application Firewall (WAF).
Im Jahr 2026 entfällt mehr als die Hälfte des weltweiten Web-Traffics auf automatisierte Systeme. Eine unbedacht konfigurierte Firewall fungiert nicht selten als unsichtbarer SEO-Killer: Sie blockiert legitime Crawler, liefert JavaScript-Challenges an Headless-Browser aus und erzeugt HTTP-Fehlercodes, die im Monitoring traditioneller CMS-Systeme unbemerkt bleiben. Wer nachhaltiges Technisches SEO und zukunftssichere Generative Engine Optimization (GEO) betreiben will, muss seine Firewall-Architektur als strategischen Erfolgsfaktor begreifen.
Jörg Zimmer
Senior SEO & AI Search Consultant
„Wird dann der UX Designer zum AX Designer? Maximale Crawler und Agenten Freundlichkeit ist eigentlich Technik SEO Aufgabe.“
Jörg Zimmer auf LinkedIn folgen →
1. Funktionsweise und Aufgaben einer Web Application Firewall
Während traditionelle Netzwerk-Firewalls lediglich IP-Adressen und Ports auf Transportebene (Layer 4) überwachen, arbeitet eine WAF auf der Anwendungsebene (Layer 7 des OSI-Modells). Sie analysiert den vollständigen HTTP/HTTPS-Datenstrom in Echtzeit:
- Erkennung von Angriffsmustern: Filterung von SQL-Injections, Cross-Site Scripting (XSS) und Zero-Day-Exploits in Webanwendungen.
- DDoS-Mitigation: Drosselung von Spitzenlasten und automatische Abwehr verteilter Denial-of-Service-Angriffe.
- Bot-Management: Klassifizierung eingehender Requests anhand von Fingerprinting, TLS-Parametern und Verhaltensmustern.
Viele moderne Webprojekte nutzen WAF-Lösungen führender Cloud-Provider. Diese Gateways sitzen direkt zwischen dem anfragenden Client und dem Hosting-Server. Erkennt die WAF eine Anomalie, bricht sie die Verbindung sofort mit einem HTTP 403 Forbidden ab oder schaltet eine Challenge-Seite (z. B. ein interaktives Captcha) vor. Was Cyberkriminelle abwehrt, wird für automatisierte Crawler jedoch zur unüberwindbaren Hürde.
2. Die Differenzierung der Bot-Klassen im KI-Zeitalter
Das größte Missverständnis bei der WAF-Konfiguration ist die binäre Einteilung in „Mensch“ und „Bot“. Im Jahr 2026 existieren drei völlig unterschiedliche Kategorien von automatisiertem Datenverkehr:
| Bot-Kategorie | Typische Vertreter | Zweck & Funktionsweise | Empfohlene WAF-Aktion |
|---|---|---|---|
| Verifizierte Suchmaschinen | Googlebot, Bingbot | Indexierung für klassische SERPs & Rich Results | Allow / Bypass (Höchste Priorität) |
| Generative Live-Agenten | OAI-SearchBot, PerplexityBot | Retrieval-Augmented Generation für direkte KI-Antworten | Allow (Sichert Zitationsanteile) |
| Reine AI-Trainingsbots | CCBot, Bytespider, GPTBot | Massenhafter Datenabzug für künftige Modellgenerationen | Rate-Limit / Block (Ressourcenschutz) |
| Bösartige Scraper & Spammer | Vulnerability Scanner, Form-Spam | Ausnutzen von Sicherheitslücken, Daten-Scraping | Block (Sofortige Sperre) |
Wird die AI Crawlability durch pauschale Blockaden beschnitten, schneidet sich ein Unternehmen von der rasant wachsenden Nutzerschaft generativer Antwortmaschinen ab. Suchmaschinenbetreiber wie Google und Microsoft nutzen zudem sogenannte „Mixed-Purpose-Crawler“, die sowohl für die Webindexierung als auch für KI-Modelltrainings eingesetzt werden. Wird hier ein pauschaler Schalter für „Block AI Training“ umgelegt, verweigert die WAF auch dem Googlebot den Zugriff – katastrophale Rankingverluste sind die direkte Konsequenz.
3. Best Practices für WAF-Regeln: Legitime Bots priorisieren
Eine saubere WAF-Architektur arbeitet nach dem Prinzip der gestaffelten Regelführung. Regeln zur Freigabe legitimer Suchsysteme müssen in der Hierarchie stets an oberster Stelle platziert werden, bevor restriktive Sicherheitsfilter greifen.
Das nachfolgende Regelbeispiel illustriert eine typische WAF-Expression (wie sie bei modernen Cloud-Providern zum Einsatz kommt), um verifizierte Bots von nachgelagerten Sicherheits-Challenges auszunehmen:
# Regel 1: Verifizierte Suchmaschinen und GEO-Search-Bots immer erlauben
(cf.client.bot) or (http.user_agent contains "OAI-SearchBot") or (http.user_agent contains "PerplexityBot")
=> Action: Bypass / Allow

# Regel 2: Bekannte aggressive Scraping-Dienste drosseln
(http.user_agent contains "Bytespider") and not (cf.client.bot)
=> Action: Block

# Regel 3: Sicherheits-Challenge für verdächtige Anfragen aktivieren
(cf.threat_score gt 40) and not (cf.client.bot)
=> Action: Managed Challenge
Durch diese Konfiguration wird verhindert, dass legitime Crawler an Captchas scheitern. Da Suchmaschinen-Bots keine interaktiven JavaScript-Prüfungen lösen können, führen vorgeschaltete Challenges unweigerlich zum Abbruch des Crawling-Prozesses.
Arbeitsanweisung für deinen KI-Agenten (Cursor / Claude / Antigravity)
Kopiere diesen Prompt direkt in deinen KI-Coding-Assistenten, um die WAF- und Firewall-Regeln für legitime Crawler automatisiert zu auditieren:
# Prompt: WAF & Bot-Bypass Audit für Search- und AI-Crawler
Rolle: Du bist ein hochspezialisierter Technical SEO & Cloud Security Architect.
Aufgabe: Analysiere und optimiere die Web Application Firewall (WAF) und Bot-Management-Regeln des Projekts. Stelle sicher, dass verifizierte Suchmaschinen (Googlebot, Bingbot) und legitime KI-Agenten (OAI-SearchBot, PerplexityBot) uneingeschränkten Zugriff erhalten, ohne an Managed Challenges oder Geo-Blocks zu scheitern.
# Vorgehensweise & Sicherheitsregeln:
1. Tech-Stack-Analyse (Erst prüfen, dann handeln): Ermittle Webserver, CDN und WAF-Anbieter (Cloudflare, AWS CloudFront/WAF, Fastly, Akamai, Nginx WAF, ModSecurity) sowie vorhandene CMS-Sicherheitsmodule. Prüfe, ob Bot Fight Mode oder automatisierte Challenge-Filter aktiv sind.
2. Defensive & konfliktfreie Integration: Blockiere niemals pauschal ganze IP-Blöcke oder ASN-Netzwerke von Suchmaschinen. Nutze native Verifizierungsmechanismen (wie cf.client.bot) oder Reverse-DNS-Verifikation (PTR-Record auf .googlebot.com / .google.com). Schalte Bypass-Regeln für verifizierte Bots stets an oberste Stelle der Regelführung.
3. Standard- & URL-Hygiene: Verwende ausschließlich standardisierte Platzhalter wie https://[deine-domain.de]/ und verifiziere, dass keine SEO-relevanten Statuscodes (403 Forbidden, 429 Too Many Requests, 503 Service Unavailable) an legitime Bots ausgeliefert werden.
4. Pre-Flight-Validierung: Simuliere Crawler-Requests per CLI (z. B. via curl mit Googlebot-User-Agent und verifizierter Test-IP) und validiere den HTTP-Statuscode (muss HTTP 200 sein, keine Challenge-HTML-Antwort). Dokumentiere die Prüfschritte transparent.
Output: 1. Befund der aktuellen WAF- & Bot-Regeln, 2. Angepasste Regelsätze (Expression / Config-Diff) mit Priorisierung verifizierter Bots, 3. Validierungsanleitung via Terminal / DevTools.
4. Typische Praxisfehler bei der Firewall-Konfiguration
In technischen Audits stoßen wir regelmäßig auf Konfigurationsfehler, die gravierende SEO-Schäden verursachen:
- Pauschales Geo-Blocking von Hosting-Regionen: Viele Administratoren sperren Zugriffe aus fremden Ländern. Da Google, Microsoft und OpenAI Rechenzentren weltweit betreiben, werden verifizierte Crawler versehentlich ausgesperrt.
- Die Annahme, dass die robots.txt genügt: Eine Robots.txt ist eine freiwillige Richtlinie für Suchmaschinen, stellt jedoch keine Sicherheitsbarriere dar. Böswillige Bots ignorieren sie. Umgekehrt schützt eine Robots.txt nicht davor, dass eine übervorsichtige WAF den Googlebot blockiert.
- Mangelnde Überwachung in den Webmaster-Tools: Wenn die WAF Crawler sporadisch blockt, melden Google und Bing verzögerte Crawling-Fehler. Regelmäßige Checks über die Google Search Console sind unverzichtbar.
Notfallprotokoll: Das Break-Glass-Verfahren bei Bot-Aussperrungen
Wird im Monitoring ein rapider Einbruch von Impressionen oder ein sprunghafter Anstieg von 403-Fehlern in der Google Search Console festgestellt, muss sofort ein standardisiertes Notfallprotokoll greifen:
- WAF-Regeln temporär entschärfen: Verdächtige Bot-Challenge-Regeln werden sofort in den Monitoring-Modus (Log only) versetzt, anstatt Anfragen hart zu blockieren.
- Reverse-DNS-Verifikation durchführen: Echte Suchmaschinen-Crawler weisen verifizierbare Hostnamen auf (z. B.
crawl-***.googlebot.com). Über automatisierte rDNS-Prüfungen lässt sich sicherstellen, dass nur gefälschte User-Agents geblockt werden. - URL-Prüfung und Re-Indexing anstoßen: In der Search Console wird der Live-Test für zentrale Einstiegsseiten ausgeführt. Bestätigt das Tool den erfolgreichen Zugriff, wird das Crawling wie im Leitfaden Crawling vs. Indexing beschrieben reaktiviert.
5. Monitoring und kontinuierliche Optimierung
Um Ausfälle zu verhindern, sollten WAF-Logfiles wöchentlich analysiert werden. Filtere nach Statuscodes wie 403 Forbidden und prüfe, ob IPs verifizierter Suchsysteme betroffen sind. Kombiniere dies mit einer automatisierten Crawling-Überwachung über SE Ranking (Partnerlink) und überwache deine generative Sichtbarkeit mit Rankscale (Partnerlink), um Blockaden von Antwortmaschinen sofort zu erkennen. Zudem sichert eine performante WAF-Konfiguration optimale PageSpeed-Werte, da Serverressourcen für echte Nutzer und wertvolle Bots geschont werden.
WAF, Bot-Management & SEO auf LinkedIn diskutieren
Diskutiere mit Jörg Zimmer und der SEO-Community auf LinkedIn über Web Application Firewalls, Bot-Filter und Crawler-Freigaben.
Beitrag auf LinkedIn öffnenWas ist eine Web Application Firewall (WAF)?
Wie kann eine falsch konfigurierte WAF das SEO zerstören?
Sollten KI-Crawler in der WAF pauschal geblockt werden?
Weitere spannende Themen
- AI Visibility Audit (AEO & GEO Audit)
- SEO Visibility Tools vs. AI Visibility Tools
- Client-Side Rendering (CSR): Risiken für SEO & KI
- Server-Side Rendering (SSR): Der Turbo für SEO & KI-Crawlability
- Was ist Two-Wave Indexing? SEO & Rendering
- FAQ Markup: Harte Daten für deine RAG-Pipeline
- Strukturierte Daten: Grounding & LLM-Fütterung
ℹ️ Transparenz-Hinweis zu Partnerlinks
Einige Links in diesem Beitrag sind sogenannte Partnerlinks (mit einem Sternchen * oder als solche gekennzeichnet). Wenn du über einen dieser Links ein Tool buchst oder testest, erhalte ich gegebenenfalls eine kleine Provision. Der Preis für dich bleibt exakt derselbe – du unterstützt damit meine unabhängigen Tests und Praxisberichte.
Willst du dieses Thema sauber für deine Domain umsetzen?
Ich bin Jörg Zimmer, unabhängiger Senior SEO & AI Visibility Freelancer (und Teil unseres spezialisierten Freelancer-Teams). In meiner 2-stündigen 1:1 SEO- & KI-Sprechstunde (480 € Festpreis) prüfe ich deine Website live per Screensharing auf technische Handbremsen, Schema.org-Entitäten und KI-Sichtbarkeit – direkt von mir als Senior-Experte, ohne Agentur-Overhead und ohne Vertragsbindung.