Erstellt: 18. September 2026 • Zuletzt aktualisiert: 17. September 2026
Confidence Score: Wie Suchmaschinen & KI Vertrauen messen
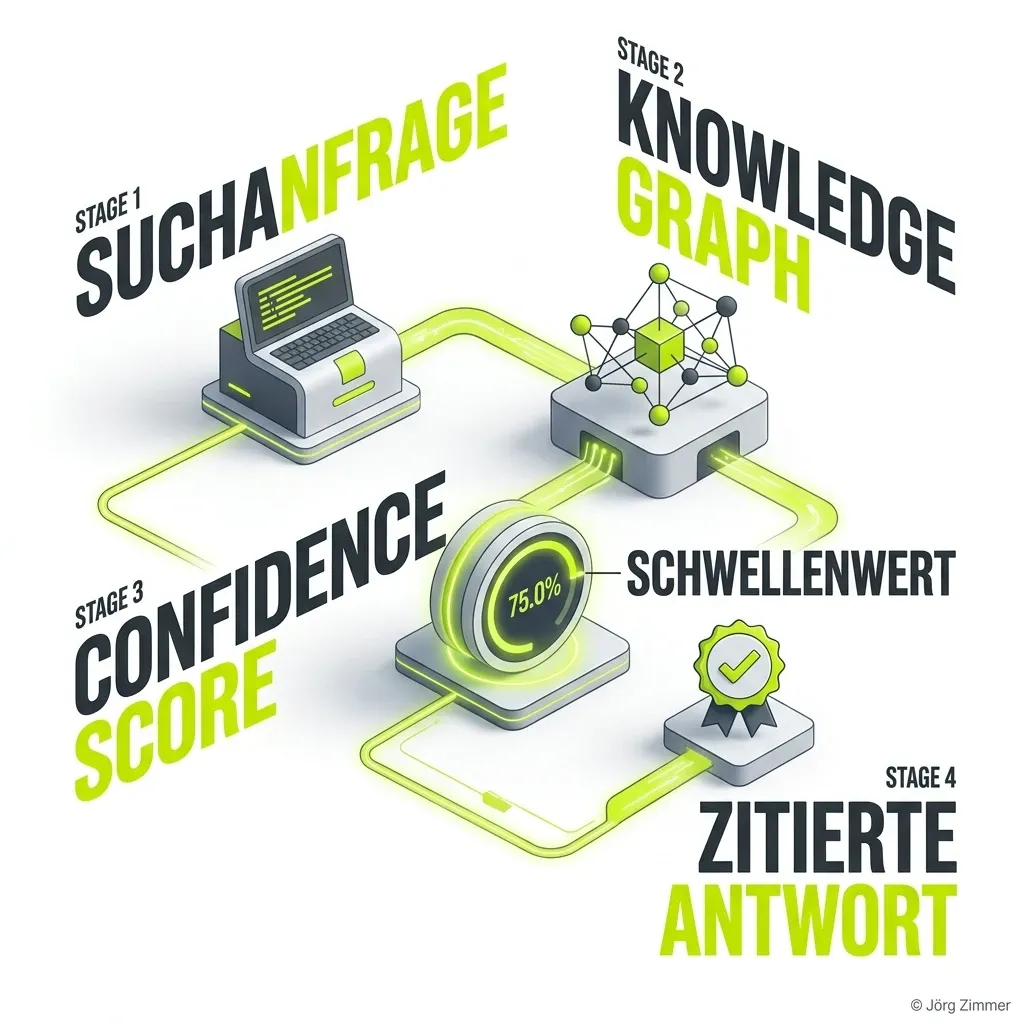
Wichtigste Erkenntnisse
- Der Confidence Score beziffert die mathematische Wahrscheinlichkeit, mit der ein Algorithmus eine Information als wahr und eine Entität als eindeutig einstuft.
- In der Google Knowledge Graph Search API fungiert der resultScore als relative Vertrauensmetrik für Disambiguierung und Knowledge-Panel-Ausspielungen.
- Large Language Models und RAG-Systeme nutzen harte Konfidenz-Schwellenwerte (Thresholds), um bei ungesicherten Fakten Halluzinationen durch Antwortverweigerung zu verhindern.
- Monolithische Schema.org-Graphen, konsistente NAP-Daten und autoritative sameAs-Verweise sind die drei wirksamsten Hebel zur Steigerung des Confidence Scores.
Künstliche Intelligenz und moderne Suchmaschinen arbeiten nicht mit absolutem Wissen. Sie operieren mit mathematischen Wahrscheinlichkeiten. Wenn ein System wie Google, Perplexity oder ChatGPT eine Suchanfrage analysiert, durchsucht es keine Tabellen nach starren Ja-Nein-Kriterien. Stattdessen berechnen neuronale Netze und probabilistische Modelle kontinuierlich, wie zuverlässig eine gefundene Information ist.
Der Confidence Score (im Deutschen oft als Konfidenzwert oder Zuverlässigkeitsindex bezeichnet) ist die entscheidende Kennzahl dieses Prozesses. Er quantifiziert die algorithmische Gewissheit darüber, dass eine erkannte Entität tatsächlich existiert, dass eine Eigenschaft korrekt zugeordnet wurde und dass ein Dokument die gestellte Frage wahrheitsgetreu beantwortet. Wer im modernen Entity SEO und in der generativen Suche sichtbar bleiben will, muss verstehen, wie dieser Wert zustande kommt und welche Hebel ihn nach oben treiben.
Die Mechanik: Wie Algorithmen Vertrauen in Zahlen fassen
Suchmaschinen und KI-Modelle unterscheiden sich fundamental von menschlichen Redakteuren. Wo ein Mensch Intuition nutzt, verlangt der Algorithmus Vektordistanzen und statistische Signale. Der Confidence Score entsteht selten isoliert, sondern resultiert aus der Verknüpfung dreier technischer Schichten.
Zunächst prüft das System die Identitätsgewissheit (Entity Disambiguation). Lautet die Suchanfrage beispielsweise auf einen Unternehmensnamen, existieren im Web oft Dutzende Firmen, Vereine oder Personen mit identischer oder ähnlicher Bezeichnung. Der Algorithmus gleicht geographische Koordinaten, Branchendefinitionen und Webadressen ab. Stimmen alle Signale überein, steigt der Konfidenzwert der Entität.
Die zweite Schicht betrifft die Faktenkonsistenz. Findet ein Web-Crawler auf der offiziellen Unternehmensseite ein Gründungsjahr von 2001, im Handelsregister jedoch 2004 und auf Wikipedia 1999, kollabiert die Konfidenz. Sprachmodelle reagieren auf solche Widersprüche hochgradig allergisch. Sie stufen widersprüchliche Daten als unsicher ein, um Halluzinationen zu vermeiden.
Die dritte Schicht misst die semantische Übereinstimmung (Relevance Confidence). Hierbei wandeln Embedding-Modelle den Suchbegriff und den extrahierten Textabschnitt in hochdimensionale Vektoren um. Über Metriken wie die Kosinus-Ähnlichkeit (Cosine Similarity) berechnet das System, wie nah der Inhalt der Suchintention mathematisch kommt.

Jörg Zimmer
Senior SEO & AI Search Consultant
„An 1. Stelle steht immer die saubere Indizierung. Ja, das ist langweiliges technisches SEO, es ist aber die Grundlage für alles andere.“
Google Knowledge Graph Search API: Der resultScore in der Praxis
In Googles Wissensarchitektur wird der Confidence Score über ein konkretes Feld offengelegt: den sogenannten resultScore innerhalb der Knowledge Graph Search API. Wer diesen Endpunkt abfragt, erhält Einblick in Googles maschinelles Bewusstsein.
Der resultScore ist kein prozentualer Wert zwischen 0 und 100 %. Es handelt sich um eine relative Ranking-Kennzahl, die das Zusammenspiel aus Entitätsautorität, Verknüpfungsdichte im Knowledge Graph und Übereinstimmung mit dem übergebenen Such-String abbildet. Globale Marken wie Apple oder Microsoft erzielen astronomische Werte von mehreren Zehntausend Punkten. Regionale B2B-Unternehmen, Freiberufler oder Nischenspezialisten starten häufig im zweistelligen oder niedrigen dreistelligen Bereich.
Liegt der Score unter einem internen Schwellenwert, verweigert Google die Ausspielung eines Knowledge Panels auf der rechten SERP-Seite. Die Suchmaschine stuft die Wahrscheinlichkeit einer Verwechslung als zu riskant ein. Erst wenn durch kontinuierliche Entitätenarbeit und sauberes Markup der Score ansteigt, schaltet der Algorithmus erweiterte SERP-Features frei.
# Universelle API-Abfrage des Knowledge Graph resultScores (cURL)
curl -s "https://kgsearch.googleapis.com/v1/entities:search?query=DEIN_UNTERNEHMENSNAME&key=DEIN_API_KEY&limit=1&indent=True" \
  | grep -E "(name|resultScore|@id)"
Das obige Snippet demonstriert den minimalen Prüfpfad. Wer seinen eigenen resultScore überwacht, erkennt sofort, ob Google die Domain als primäre Quelle anerkennt oder ob Namensvettern im Ranking bevorzugt werden.
Confidence Thresholds in RAG-Pipelines und Answer Engines
Während Google den resultScore primär zur Entitäten-Konsolidierung nutzt, gehen Answer Engines wie Perplexity, SearchGPT oder Claude einen Schritt weiter. Sie binden Confidence Scores direkt in ihre RAG-Pipelines ein.
Eine moderne RAG-Architektur arbeitet mit strikten Confidence Thresholds (Abbruch-Schwellen):
- Retrieval Score: Der Vektor-Index filtert Dokumentenabschnitte nach semantischer Relevanz. Text-Chunks mit einer Cosine Similarity unterhalb des Schwellenwerts (beispielsweise 0,65) werden sofort eliminiert.
- Re-Ranking Confidence: Ein Cross-Encoder prüft die verbliebenen Chunks im Kontext der Gesamtanfrage. Er bewertet, ob der Abschnitt die Frage tatsächlich beantwortet oder nur thematisch berührt.
- Faithfulness Evaluation: Das Modell prüft vor der Textgenerierung, ob die Antwort zu 100 % aus den bereitgestellten Quellen belegt werden kann.
- Abstention Path (Antwortverweigerung): Sinkt die Gesamtkonfidenz unter das Sicherheitslimit, verweigert die KI eine konkrete Behauptung. Stattdessen gibt sie eine neutrale Floskel aus oder ignoriert die unsichere Website als Zitationsquelle.
Für Unternehmen bedeutet das eine harte Realität: Selbst wenn dein Blogartikel die beste fachliche Erklärung liefert, wird er von Answer Engines ignoriert, wenn dem System die strukturelle Konfidenz fehlt.
Token-Logprobs und Entropie: Wie generative Sprachmodelle intern rechnen
Hinter den Benutzeroberflächen von ChatGPT, Perplexity und Claude steckt kein rationales Denkorgan. Sprachmodelle sind prädiktive Textgeneratoren. Bei jedem einzelnen Wortschritt (Token) berechnet das Modell eine Wahrscheinlichkeitsverteilung über den gesamten Wortschatz. Diese Werte werden in der Informatik als Logarithmic Probabilities (Logprobs) bezeichnet.
Liegt die Wahrscheinlichkeit für das nächste logische Token bei 98 %, operiert das Modell in einer Zone minimaler Entropie. Es herrscht maximale Konfidenz. Typisches Beispiel: „Die Hauptstadt von Frankreich ist [Paris]“. Hier divergieren die Wahrscheinlichkeiten kaum.
Sobald es jedoch um fachspezifische Detailfragen, B2B-Nischen oder widersprüchliche Firmenprofile geht, fächert sich die Verteilung auf. Wenn fünf verschiedene Antwortpfade jeweils 20 % Wahrscheinlichkeit aufweisen, steigt die Shannon-Entropie sprunghaft an. Die Modell-Unsicherheit (Perplexity) erreicht kritische Werte. An dieser Weggabelung entscheiden moderne Answer Engines über Sicherungsmechanismen:
- Entweder greift das System auf vorgefilterte RAG-Quellen zurück, um die Entropie künstlich zu senken.
- Oder das Modell fällt in eine sogenannte „halluzinierte Falschgewissheit“, bei der es mit selbstbewusstem Tonfall unzutreffende Fakten generiert.
- In sicherheitskritischen Umgebungen (wie medizinischen oder juristischen Anfragen) triggert eine hohe Entropie einen harten Fallback-Pfad: Die Antwort wird abgebrochen oder mit einem standardisierten Disclaimer versehen.
Knowledge Graph Embeddings: Geometrische Distanzen im Vektorraum
Neben Wahrscheinlichkeitswerten bei der Textausgabe spielt die geometrische Modellierung im Knowledge Graph eine zentrale Rolle. Moderne Suchmaschinen nutzen Algorithmen wie TransE, RotatE oder ComplEx, um Entitäten und ihre Beziehungen in niedrigdimensionale Vektorräume zu transformieren.
In diesem mathematischen Modell wird ein Fakten-Tripel aus Subjekt, Prädikat und Objekt – beispielsweise (Jörg Zimmer, Beruf, SEO-Consultant) – als Vektortranslation abgebildet:
$$\vec{h} + \vec{r} \approx \vec{t}$$
Der Vektor des Kopf-Knotens ($\vec{h}$) addiert mit dem Beziehungsvektor ($\vec{r}$) muss im Idealfall nahe am Zielvektor ($\vec{t}$) liegen. Der euklidische Abstand oder die Projektionsdistanz zwischen den Punkten fungiert als direkter Confidence Score der Relation.
Veröffentlicht eine Website sauberes Schema-Markup, das diese Beziehungen formalisiert, schrumpft die geometrische Distanz im Wissensgraphen. Suchmaschinen können den Wahrheitsgehalt der Beziehung ohne aufwendige Textanalyse deterministisch verifizieren.
Praxisszenario: High-Confidence versus Low-Confidence im B2B-Vergleich
Wie gravierend sich der Confidence Score im realen Wettbewerb auswirkt, zeigt ein direkter Vergleich zweier spezialisierter Maschinenbau-Zulieferer:
- Unternehmen A (Low-Confidence Setup): Die Website nutzt ein Standard-CMS ohne konsistentes Schema-Markup. Die Adresse im Impressum unterscheidet sich minimal von Google Maps, auf Wikidata existiert kein Eintrag, und in PDF-Katalogen werden andere Produktbezeichnungen verwendet als im Webshop. Folge: Der
resultScorein der Google Knowledge Graph Search API dümpelt bei 12 Punkten. Answer Engines wie Perplexity finden zwar Textabschnitte, verwerfen diese jedoch wegen fehlendem Faktenkonsens an der Schwellenwert-Grenze (Threshold 0,65). Die Domain taucht in KI-Antworten schlicht nicht auf. - Unternehmen B (High-Confidence Setup): Alle Produktserien und Unternehmensdaten sind in einem monolithischen
@graph-Container mit eindeutigen@id-Fragmenten verankert. Eine dedizierte Grounding Page stellt maschinenlesbare Fakten bereit. Externe Profile auf LinkedIn und in Branchenverzeichnissen verweisen bidirektional auf dieselben Entitäts-IDs. Folge: DerresultScoreklettert auf über 450 Punkte. Perplexity und SearchGPT identifizieren das Unternehmen als autoritäre Primärquelle und listen es bei Anfragen nach „führenden Herstellern für Industrieventile“ mit verlinkter Zitation auf Rang 1.
Die folgende Matrix veranschaulicht, wie unterschiedliche Systeme algorithmisches Vertrauen quantifizieren:
| Dimension | Google Knowledge Graph API | RAG Vector Retrieval (z. B. Perplexity) | Large Language Models (z. B. GPT-4o) |
|---|---|---|---|
| Metrik-Bezeichnung | resultScore | Kosinus-Ähnlichkeit & Cross-Encoder Score | Token Log-Probabilities (Logprobs) |
| Wertebereich | Relativ (0 bis > 50.000) | Normalisiert (0,0 bis 1,0) | Logarithmische Wahrscheinlichkeit (-(\infty) bis 0) |
| Messgegenstand | Entitätsautorität & Namens-Disambiguierung | Semantische Textdeckung pro Chunk | Vorhersage-Sicherheit des nächsten Tokens |
| Primäre Datenbasis | Wikidata, Handelsregister, Schema.org | Vektor-Embeddings, Markdown, HTML-Semantik | Vortrainierte Modellgewichte & RAG-Kontext |
| Konsequenz bei niedrigem Wert | Kein Knowledge Panel, Verwechslungsgefahr | Ausschluss aus RAG-Kontext (keine Zitation) | Generierungsabbruch oder Halluzinationsgefahr |
Die 3 häufigsten Praxis-Fehler bei der Konfidenz-Optimierung
In über 25 Jahren SEO-Praxis und Hunderten von Audits zeigt sich immer wieder das gleiche Bild: Viele Agenturen investieren Unsummen in Texterstellung, vernachlässigen aber die mathematischen Vertrauenssignale.
1. Isolierte Dateninseln im JSON-LD Markup
Wer strukturierte Daten über mehrere separate Plugins einbindet, erzeugt oft ein Desaster. Das SEO-Plugin rendert eine Organization, das Shop-Plugin ein Product und das Bewertungs-Tool ein AggregateRating – jeweils in getrennten Script-Blöcken ohne verbindende @id-URIs. Für den Crawler existieren drei voneinander losgelöste Entitäten. Die Identitätskonfidenz bricht ein. Um solche Fragmentierungen aufzudecken, lohnt sich ein systematischer Test im Schema-Graph-Visualizer, der unverbundene Knoten visualisiert.
2. Fehlende oder falsche sameAs-Referenzen
Suchmaschinen benötigen Bestätigung durch unabhängige Dritte. Wer in seinen Entitäts-Auszeichnungen auf sameAs-Verlinkungen zu Wikidata, Wikipedia, dem Bundesanzeiger oder verifizierten LinkedIn-Profilen verzichtet, zwingt den Algorithmus zum Raten. Jede Unklarheit senkt den Confidence Score. Ebenso fatal sind veraltete Social-Media-Links auf tote Profile.
3. Asynchrone NAP- und Kontaktdaten
Name, Address, Phone (NAP) müssen netzweit buchstabengetreu übereinstimmen. Wenn im Impressum „Muster GmbH & Co. KG“ steht, auf Google Maps „Muster GmbH“ und in Branchenverzeichnissen die alte Firmenadresse von vor drei Jahren, sinkt die algorithmische Berechenbarkeit. Systeme wie ChatGPT erkennen die Unstimmigkeit und ziehen Wettbewerber mit konsistenten Daten vor.
Wie du deinen Confidence Score systematisch steigerst
Um den Vertrauenswert deiner Website für Suchmaschinen und KI-Agenten messbar anzuheben, hat sich in der technischen Umsetzung eine vierstufige Methodik bewährt:
Zunächst baust du ein monolithisches Wissensnetz auf. Führe alle strukturierten Daten in einem einzigen @graph-Container zusammen. Verknüpfe Personen, Standorte, Produkte und Autoren über relationale @id-Hierarchien (z. B. https://deinedomain.de/#organization).
Als zweiter Schritt folgt die Einrichtung einer dedizierten Grounding Page. Diese Seite dient als maschinenlesbare Faktensammlung. Sie liefert Gründungsdaten, Steuernummern, Handelsregister-IDs, Kernkompetenzen und Management-Biografien in klar strukturierter Tabellen- und Schema-Form – ohne werbliche Ausschmückungen.
Drittens etablierst du ein permanentes Monitoring. Klassische Rank-Tracker erfassen meist nur Keyword-Positionen, übersehen aber Entitäten-Veränderungen. Zur ganzheitlichen Kontrolle der technischen Onpage-Integrität und des Backlink-Graphen empfiehlt sich der Einsatz von SE Ranking (Partnerlink). Wer zusätzlich präzise überwachen will, ob Sprachmodelle wie Perplexity oder ChatGPT die eigene Marke bei Branchenanfragen mit hoher Konfidenz zitieren, nutzt das spezialisierte KI-Tracking von Rankscale (Partnerlink).
Viertens führst du in regelmäßigen Intervallen ein technisches AI Visibility Audit durch. Dabei überprüfst du, ob Crawler wie GPTBot, PerplexityBot oder Google-Extended ungehinderten Zugriff auf deine Wissensressourcen haben und ob die Antworten der Maschinen stabil bleiben.
Jetzt an der Diskussion teilnehmen
Diskutiere mit Jörg Zimmer und der SEO-Community auf LinkedIn über Entitäten-Konfidenz, Knowledge Graphs und moderne RAG-Rankings.
Jörg Zimmer auf LinkedIn kontaktierenWas misst der Confidence Score im Kontext von Suchmaschinen und KI?
Welche Rolle spielt der resultScore in der Google Knowledge Graph Search API?
Wie beeinflusst der Confidence Score Zitationen in RAG-Pipelines wie Perplexity oder ChatGPT?
Mit welchen Maßnahmen lässt sich der Confidence Score einer Domain gezielt steigern?
Weitere spannende Themen
- Knowledge Graph: Gehirn der generativen Suche
- KGMID: Googles Knowledge Graph Machine ID im SEO
- Open Knowledge Graph: Offene Wissensnetze für KI & SEO
- Wikidata SEO: Entitäten & sameAs im Knowledge Graph
- Disambiguierung: Entitäten eindeutig im Graph verankern
- Named Entity Recognition (NER): Wie KI Entitäten versteht
- Entity Co-Occurrence: Kookkurrenz in der KI-Suche (SEO)
ℹ️ Transparenz-Hinweis zu Partnerlinks
Einige Links in diesem Beitrag sind sogenannte Partnerlinks (mit einem Sternchen * oder als solche gekennzeichnet). Wenn du über einen dieser Links ein Tool buchst oder testest, erhalte ich gegebenenfalls eine kleine Provision. Der Preis für dich bleibt exakt derselbe – du unterstützt damit meine unabhängigen Tests und Praxisberichte.
Nichts mehr verpassen?
Folge mir auf LinkedIn für tägliche SEO-Nuggets und diskutiere mit anderen Experten.
LinkedIn-Profil besuchen →