Erstellt: 11. März 2026 • Zuletzt aktualisiert: 8. Oktober 2026
Named Entity Recognition (NER): Wie KI Entitäten versteht
Wichtigste Erkenntnisse
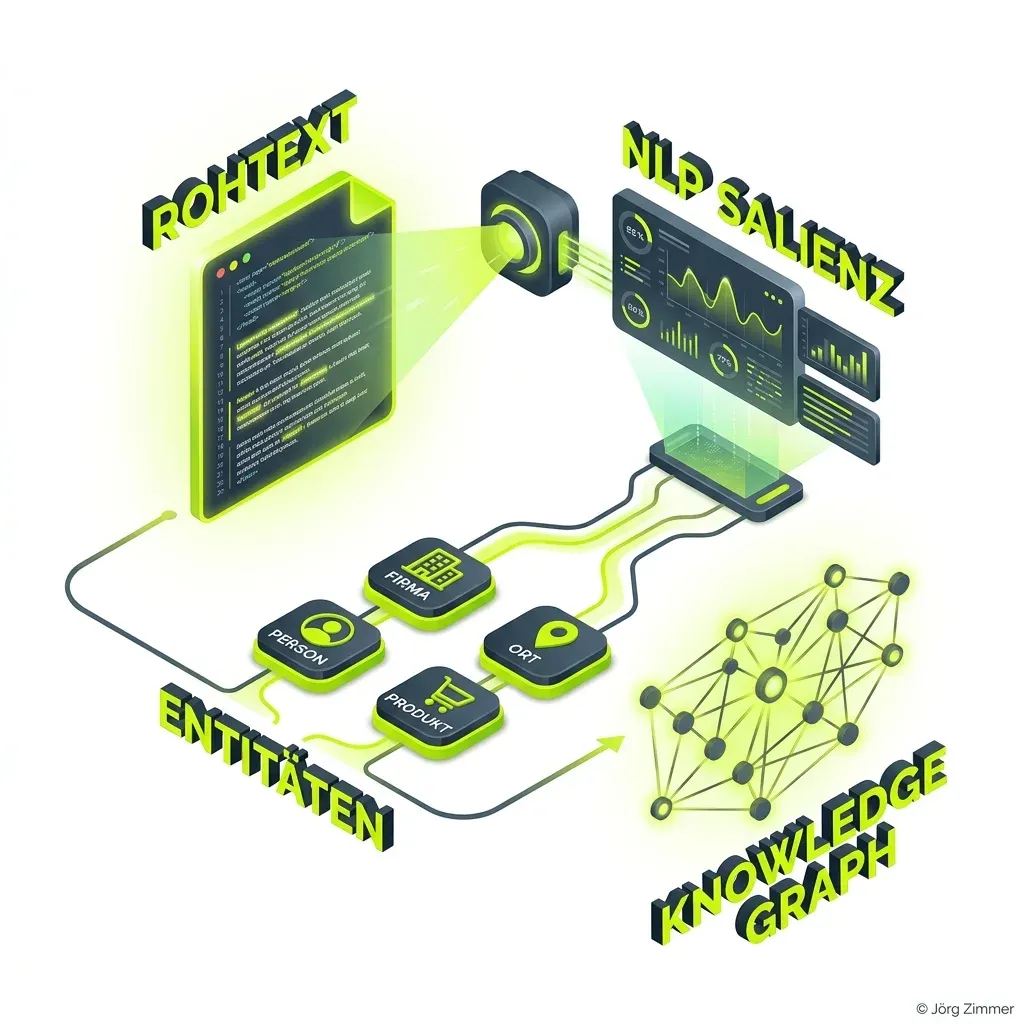
- Named Entity Recognition (NER) ist ein NLP-Verfahren, das Entitäten (Personen, Organisationen, Orte, Produkte) aus unstrukturiertem Fließtext extrahiert.
- Google nutzt NER und die Cloud Natural Language API, um die thematische Salienz (Wichtigkeit) von Entitäten auf Webseiten zu bestimmen.
- Eine hohe Salienz der Ziel-Entität signalisiert Suchmaschinen und LLMs, worum es im Kern des Dokuments wirklich geht.
- Durch maschinenlesbares Schema.org JSON-LD Markup nimmst du KI-Systemen die Interpretationsarbeit ab und verhinderst Extraktionsfehler.
Was ist Named Entity Recognition (NER)?
Die Named Entity Recognition (NER) – im Deutschen auch als Entitätserkennung bezeichnet – ist eine grundlegende Disziplin des Natural Language Processing (NLP) und des Machine Learning. Sie beschreibt die Fähigkeit von Algorithmen, in unstrukturierten Textdokumenten benannte Entitäten (wie Personen, Unternehmen, Orte, Produkte, Kunstwerke oder Datumsangaben) automatisch zu lokalisieren und präzisen semantischen Klassen zuzuordnen.
Für moderne Suchmaschinen und generative Antwortsysteme ist NER das entscheidende Werkzeug, um den Übergang von der reinen Textsuche zur semantischen Suche zu meistern. Wenn Google, ChatGPT oder Perplexity einen Webseitentext crawlen, zählen sie keine Keyword-Wiederholungen mehr. Sie zerlegen den Text mithilfe von NER in seine semantischen Bausteine, analysieren die Beziehungen der erkannten Entitäten und gleichen diese mit dem globalen Knowledge Graph ab.
Jörg Zimmer
Senior SEO & AI Search Consultant
„Die meisten Quellen haben tatsächlich unterschiedliche Angaben zur gleichen Sache. Das Ding mit dem Entitäten Management kann man für SEO und für GEO durchaus jetzt schon starten.“
Jörg Zimmer auf LinkedIn folgen →
Wie NER funktioniert: Vom Fließtext zur semantischen Karte
Der Prozess der Entitätserkennung durchläuft im NLP-Modell mehrere aufeinander aufbauende Phasen:
[ Unstrukturierter Webtext: "Jörg Zimmer leitet SEO-Projekte in Berlin." ]
                                   │
                                   ▼
+-------------------------------------------------------------------------+
| 1. Tokenisierung & Part-of-Speech Tagging |
| Identifikation von Eigennamen, Verben, Substantiven und Satzstrukturen |
+-------------------------------------------------------------------------+
                                   │
                                   ▼
+-------------------------------------------------------------------------+
| 2. Klassifikation (Named Entity Recognition) |
| "Jörg Zimmer" -> PERSON | "Berlin" -> LOCATION | "SEO" -> TOPIC |
+-------------------------------------------------------------------------+
                                   │
                                   ▼
+-------------------------------------------------------------------------+
| 3. Salienz-Berechnung (Salience Score) |
| Gewichtung der Wichtigkeit der Entitäten im Kontext des Dokuments |
+-------------------------------------------------------------------------+
                                   │
                                   ▼
+-------------------------------------------------------------------------+
| 4. Entity Linking & Disambiguierung |
| Abgleich mit Wikidata (Q-IDs) und Zuweisung im Knowledge Graph |
+-------------------------------------------------------------------------+- Tokenisierung: Der Text wird in einzelne Spracheinheiten zerlegt.
- Klassifikation: Machine-Learning-Klassifikatoren ordnen den Tokens Entitätstypen zu (
PERSON,ORGANIZATION,LOCATION,EVENT,CONSUMER_GOOD). - Salience (Salienz): Algorithmen ermitteln anhand syntaktischer Tiefe und Position, welche Entität das Hauptthema darstellt.
- Entity Linking: Über Disambiguierung wird die identifizierte Entität mit externen Knoten wie Wikidata verknüpft.
Salienz: Der geheime Rankingfaktor im semantischen SEO
Viele Webseiten ranken nicht für ihre Wunschthemen, weil ihre Entitäten-Salienz verwässert ist. Wenn du einen Artikel über „Enterprise SEO Beratung“ verfasst, aber 60 % des Textes über allgemeine Büromöbel oder IT-Infrastruktur sprichst, stuft die Google NLP API die falschen Entitäten als hochsalient ein.
Für erstklassige Zitationschancen in KI-Overviews und hohe Rankings im Entitäten SEO gilt:
- Fokussierte Spitzenpositionierung: Die Hauptentität muss in der H1-Überschrift, der Einleitung und den ersten 150 Wörtern klar etabliert sein.
- Semantisches Co-Occurrence Netzwerk: Verwende fachlich eng verwandte Entitäten, die das Thema logisch stützen.
- Hohe Salienzwerte: In Tests mit der Google Natural Language API sollte deine Ziel-Entität einen Salience-Wert von über 0.30 bis 0.50 aufweisen.
- Robuste Faktenbasis: Je konsistenter deine Aussagen mit der Ground Truth übereinstimmen, desto höher fällt der Confidence Score aus.
Quellcode schlägt Textinterpretation: Schema.org als NER-Abkürzung
Obwohl NLP-Systeme hochentwickelt sind, beruht Textanalyse stets auf Wahrscheinlichkeiten. Crawler müssen raten und interpretieren. Mit strukturiertem Schema.org Markup nimmst du der Suchmaschine diese Unsicherheit vollständig ab.
Indem du deine Entitäten direkt im JSON-LD-Format deklarierst, lieferst du die NER-Klassifikation und das Entity Linking vorab servierfertig mit. Nutze einen modernen Schema Markup Generator oder baue deine Relationen mit unserem interaktiven Entitäten Graph Generator. Die visuelle Überprüfung verwaister Knoten gelingt nahtlos im Schema Graph Visualizer.
Aus der Praxis von Jörg Zimmer: Named Entity Recognition am Montagmorgen
In meinen 25 Jahren in der Suchmaschinenoptimierung – von den ersten handgemachten Webprojekten vor über 25 Jahren über die Studienjahre in Stuttgart an der HdM bis zur Beratung in Berlin-Spandau – habe ich die Entwicklung von einfachen Keyword-Dichten hin zu hochentwickelten NLP-Vektorräumen hautnah begleitet. Früher reichte es, ein Keyword dreimal in den Text zu streuen; heute analysieren Algorithmen wie die Google Natural Language API die Beziehungen zwischen Entitäten, berechnen Salienzwerte und verknüpfen sie im Wissensgraphen.
Mein Praxistipp für die handwerkliche Umsetzung am Montagmorgen: Verlasse dich nicht darauf, dass der Crawler deine Markenentität errät. Sorge dafür, dass deine Primärentität in den ersten Sätzen glasklar definiert ist, stütze sie durch präzises Schema-Markup mit sameAs-Verweisen auf Wikidata und halte deine Entitätssignale über alle Kanäle hinweg konsistent.
Jörg Zimmer
Senior SEO & AI Search Consultant
„Gerade das ganze Vertrauensthema zur Domain und zum Topic. Wie oft nach deiner Marke oder deiner URL gesucht wird. Wie du sonst so im Internet und Social Media erscheinst. Das bezahlter Traffic in das Ranking einfließen kann. Die Reputation deiner Marke mit einfließt usw. Das alles macht SEO zum Teil des Markenaufbaus.“
Beitrag auf LinkedIn ansehen →
Named Entity Recognition & Salienz diskutieren
Diskutiere mit Jörg Zimmer und der SEO-Community auf LinkedIn über Named Entity Recognition, NLP und die Zukunft semantischer Suchmaschinen.
Beitrag auf LinkedIn öffnenWas ist Named Entity Recognition (NER) genau?
Welche Rolle spielt Salienz (Salience) bei der Entitätserkennung?
Wie kann ich die Entitäten meiner Website analysieren?
Was ist der Unterschied zwischen NER und Entity Linking?
Weitere spannende Themen
- Entity Co-Occurrence: Kookkurrenz in der KI-Suche (SEO)
- AI Rank Tracker: Tracke deine Sichtbarkeit in der KI-Suche
- LLM Rank Tracker: Wie du deine KI-Sichtbarkeit wirklich misst
- LLM Optimization: Technik, RAG und Agent Readiness
- Cloudflare Agent Readiness Checklist: Der Guide
- Cloudflare Agent Readiness Scan KI-Sichtbarkeit prüfen
- AI Crawler, Markdown & Cloudflare Bot-Optimierung
Willst du dieses Thema sauber für deine Domain umsetzen?
Ich bin Jörg Zimmer, unabhängiger Senior SEO & AI Visibility Freelancer (und Teil unseres spezialisierten Freelancer-Teams). In meiner 2-stündigen 1:1 SEO- & KI-Sprechstunde (480 € Festpreis) prüfe ich deine Website live per Screensharing auf technische Handbremsen, Schema.org-Entitäten und KI-Sichtbarkeit – direkt von mir als Senior-Experte, ohne Agentur-Overhead und ohne Vertragsbindung.