Erstellt: 11. März 2026 • Zuletzt aktualisiert: 8. Oktober 2026
Disambiguierung: Entitäten eindeutig im Graph verankern
Wichtigste Erkenntnisse
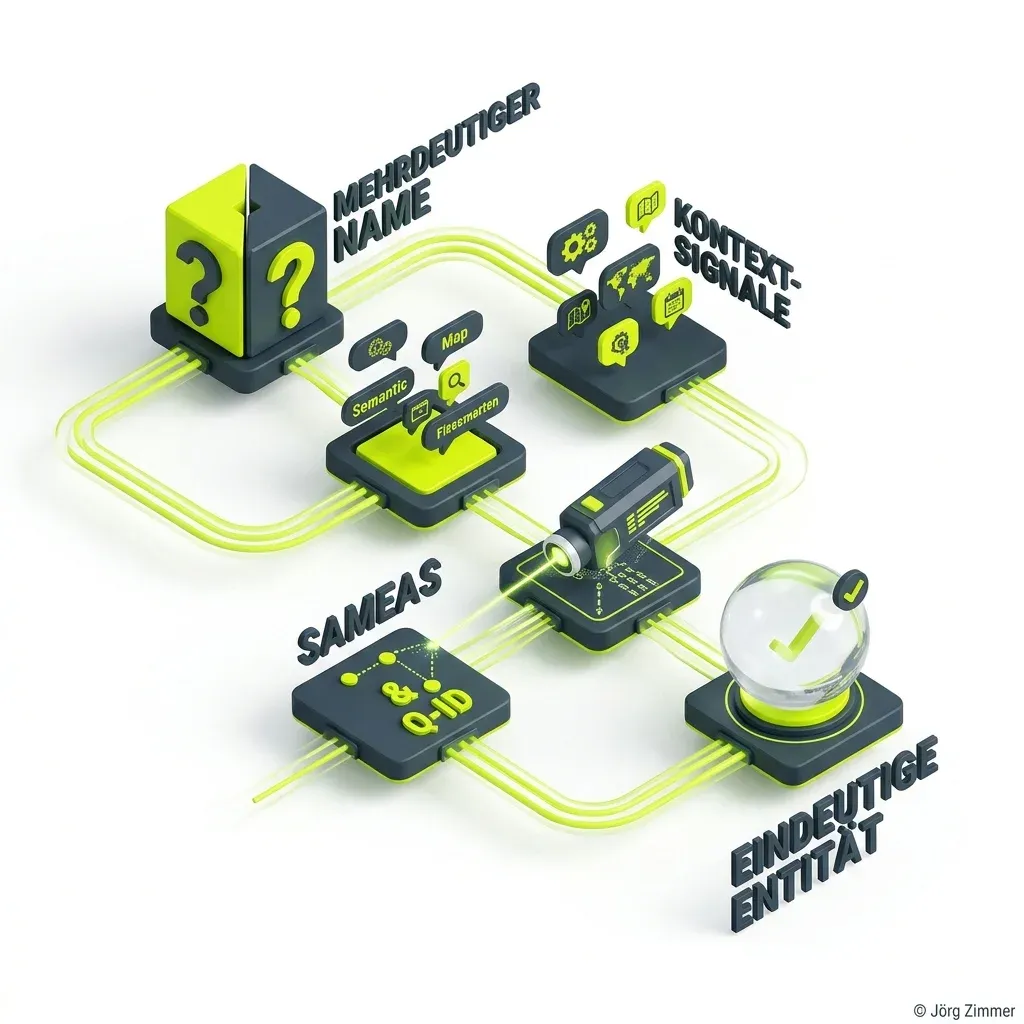
- Disambiguierung ist der algorithmische Prozess, durch den Suchmaschinen gleichnamige Begriffe und Entitäten fehlerfrei voneinander unterscheiden.
- Mehrdeutige Markennamen (Homonyme) führen ohne Disambiguierung dazu, dass Google Signale fälschlicherweise anderen Unternehmen zuordnet.
- Das sameAs-Attribut in Schema.org JSON-LD verbindet deine Website eindeutig mit Wikidata-Q-IDs und autoritativen Profilen.
- Eine saubere Disambiguierung ist die zwingende Voraussetzung für ein Google Knowledge Panel und verlässliche Zitate in KI-Suchsystemen.
Was ist Disambiguierung (Entity Disambiguation)?
In der Sprachwissenschaft und Information Retrieval beschreibt Disambiguierung (Bedeutungsauflösung) das Verfahren, mehrdeutige Wörter, Phrasen oder Namen anhand ihres Kontextes der jeweils zutreffenden Bedeutung zuzuordnen. Im Bereich Entitäten SEO und der semantischen Suche ist die Disambiguierung einer der kritischsten Kernprozesse: Suchmaschinen wie Google und KI-Answer-Engines müssen zweifelsfrei erkennen, welche reale Entität (Person, Organisation, Ort, Produkt) mit einem Textstring gemeint ist.
Trägt ein Unternehmen einen Namen wie beispielsweise „Merkur“, steht der Algorithmus vor einem Problem: Geht es um den Planeten unseres Sonnensystems, den römischen Gott der Händler, die renommierte Tageszeitung oder ein Versicherungsunternehmen? Ohne eindeutige Kontextsignale und semantische Strukturierung vermischen sich Ranking-Signale, was die Zuteilung eines Google Knowledge Panels unmöglich macht und die KI-Sichtbarkeit zerstört.
Jörg Zimmer
Senior SEO & AI Search Consultant
„Wenn das so einfach ist lege ich noch einen drauf. Sie sollen den Markennamen vorher in Google suchen und sich dann zu Maps klicken. Erhöhe dann ja auch das Suchvolumen zur Marke.“
Jörg Zimmer auf LinkedIn folgen →
Wie Algorithmen Mehrdeutigkeiten auflösen
Google und moderne Sprachmodelle nutzen ein mehrstufiges Verfahren zur Disambiguierung:
[ Mehrdeutiger Textstring (z.B. "Jaguar") ]
                    │
                    ▼
+-------------------------------------------------------+
| Schritt 1: Kontext & Co-Occurrence Analyse |  Prüfung von Nachbarwörtern
| ("Auto", "PS", "V8" vs. "Dschungel", "Raubkatze") |  im Dokument oder Query
+-------------------------------------------------------+
                    │
                    ▼
+-------------------------------------------------------+
| Schritt 2: Abgleich mit Knowledge Graph |  Prüfung vorhandener Nodes
| und Wikidata Q-IDs (Q35064 vs. Q25287) |  auf mathematische Passung
+-------------------------------------------------------+
                    │
                    ▼
+-------------------------------------------------------+
| Schritt 3: Maschinenlesbare Bestätigung |  Auswertung von JSON-LD
| via Schema.org @id und sameAs Verknüpfungen |  auf der offiziellen Domain
+-------------------------------------------------------+
                    │
                    ▼
[ Eindeutig disambiguierte Entität mit hohem Confidence Score ]- Textuelle Co-Occurrences: Welche Begriffe tauchen im unmittelbaren Umfeld auf? Wörter wie „Geschäftsführer“, „HRB-Nummer“ und „Software“ grenzen eine Firmen-Entität sofort von einem Naturphänomen ab.
- Knowledge Graph Matching: Das System gleicht die Attribute mit seiner internen Faktenbasis und Wikidata ab.
- Explizite Quellcode-Deklaration: Die verlässlichste Methode ist die direkte maschinenlesbare Deklaration im Schema.org Markup.
Das sameAs-Attribut als digitaler Fingerabdruck
Suchmaschinen können menschliche Sprache missverstehen – eindeutige Uniform Resource Identifiers (URIs) hingegen nicht. Das wirksamste Werkzeug zur Disambiguierung auf deiner eigenen Website ist das sameAs-Attribut im JSON-LD:
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Organization",
      "@id": "https://example.de/#organization",
      "name": "Nova Tech Solutions",
      "legalName": "Nova Tech Solutions GmbH",
      "url": "https://example.de/",
      "sameAs": [
        "https://www.wikidata.org/wiki/Q48522",
        "https://www.linkedin.com/company/nova-tech-solutions-berlin/",
        "https://www.northdata.de/Nova+Tech+Solutions+GmbH,+Berlin/HRB12345"
      ]
    }
  ]
}
Durch diese expliziten URIs teilst du dem Crawler unmissverständlich mit: „Verwechsle uns nicht mit den 50 anderen Unternehmen namens Nova. Wir sind die unter dieser Handelsregisternummer und diesem Wikidata-Knoten definierte Entität.“
Das Resultat: Der Confidence Score deiner Marke schnellt nach oben, weil die KI keine Halluzinationen oder Namensverwechslungen befürchten muss.
Best Practices: Disambiguierung für deine Marke meistern
- Konsistente NAP- und Stammdaten: Verwende deinen exakten rechtlichen Firmennamen (legalName) einheitlich im Impressum, auf Google Unternehmensprofilen und im Quelltext.
- Keine isolierten Daten-Inseln: Baue deinen Schema-Code mit persistenten
@id-Kennungen auf. Nutze einen Schema Markup Generator oder erstelle deinen Graphen im Entitäten Graph Generator. - Visuelle Kontrolle: Mit dem Schema Graph Visualizer erkennst du sofort, ob deine
@id-Kanten sauber geschlossen sind oder ob Knoten isoliert im Leeren hängen. - Aufbau thematischer Signale: Positioniere deine Marke gezielt in Fachmedien, damit Co-Occurrences im Knowledge Graph die Branchenzugehörigkeit festigen.
- Monitoring & Re-Verifizierung: Überprüfe in regelmäßigen Intervallen, wie Answer Engines und RAG-Pipelines deine Entität zitieren. Tritt bei generativen Antworten eine Verwechslung auf, müssen Kontext-Signale und In-Text-Entitäten auf den Landingpages nachgeschärft werden.
Aus der Praxis von Jörg Zimmer: Was Disambiguierung am Montagmorgen bedeutet
Wenn ich mir in Berlin-Spandau Kunden-Websites vornehme, die trotz jahrelangem Content-Aufbau kein Google Knowledge Panel erhalten oder in KI-Suchmaschinen wie Perplexity und ChatGPT Search mit fremden Dienstleistern verwechselt werden, liegt die Ursache fast immer im selben handwerklichen Versäumnis: fehlende oder unvollständige Disambiguierung.
In meinen 25 Jahren als SEO – von den Anfängen vor über 25 Jahren über Stuttgart bis heute – habe ich eines gelernt: Suchmaschinen und LLMs sind im Kern unbestechliche Rechenmaschinen. Wenn dein Unternehmensname auch nur den Hauch einer Mehrdeutigkeit aufweist, rät die Maschine nicht zu deinen Gunsten. Sie ordnet Signale im Zweifel dem bekannteren Knotenpunkt zu.
Mein Praxistipp für die handwerkliche Umsetzung am Montagmorgen: Verlasse dich niemals darauf, dass Google „schon verstehen wird“, wer gemeint ist. Hinterlege in deinem Schema-Markup saubere sameAs-Verknüpfungen zu Wikidata, verlinke dein Google Unternehmensprofil und ziehe deine Stammdaten im gesamten Web glatt. Echtes Handwerk schlägt Aktionismus – denn wer im Knowledge Graph nicht eindeutig isoliert ist, bleibt für moderne KI-Crawler unsichtbar.
Disambiguierung & Entity Grounding diskutieren
Diskutiere mit Jörg Zimmer und der SEO-Community auf LinkedIn über Entity Disambiguation, Knowledge Graphs und maschinenlesbare Markenidentität.
Beitrag auf LinkedIn öffnenWas bedeutet Disambiguierung im Bereich SEO?
Warum scheitern viele Marken an der Disambiguierung?
Wie hilft das sameAs-Attribut bei der Disambiguierung?
Welche Rolle spielt Entity Co-Occurrence bei der Bedeutungsauflösung?
Weitere spannende Themen
- Named Entity Recognition (NER): Wie KI Entitäten versteht
- Entity Co-Occurrence: Kookkurrenz in der KI-Suche (SEO)
- AI Rank Tracker: Tracke deine Sichtbarkeit in der KI-Suche
- LLM Rank Tracker: Wie du deine KI-Sichtbarkeit wirklich misst
- LLM Optimization: Technik, RAG und Agent Readiness
- Cloudflare Agent Readiness Checklist: Der Guide
- Cloudflare Agent Readiness Scan KI-Sichtbarkeit prüfen
Willst du dieses Thema sauber für deine Domain umsetzen?
Ich bin Jörg Zimmer, unabhängiger Senior SEO & AI Visibility Freelancer (und Teil unseres spezialisierten Freelancer-Teams). In meiner 2-stündigen 1:1 SEO- & KI-Sprechstunde (480 € Festpreis) prüfe ich deine Website live per Screensharing auf technische Handbremsen, Schema.org-Entitäten und KI-Sichtbarkeit – direkt von mir als Senior-Experte, ohne Agentur-Overhead und ohne Vertragsbindung.