Erstellt: 18. September 2026 • Zuletzt aktualisiert: 17. September 2026
Schema Markup Generator: Vom Inselschnipsel zum Wissensgraphen
Wichtigste Erkenntnisse
- Herkömmliche Schema Markup Generatoren erzeugen isolierte Einzel-Snippets, die im Quellcode als unverbundene Dateninseln enden.
- Moderne KI-Suchmaschinen und LLMs verlangen relationale @graph-Container mit eindeutigen @id-Fragment-URIs statt loser Attribut-Sammlungen.
- Ein professioneller Generator verknüpft Personen, Organisationen, Angebote und Webseiten über semantische Kanten wie founder, publisher und provider.
- Vor der Produktivschaltung ist die Überprüfung auf Dateninseln im Graph-Visualizer ebenso entscheidend wie der reine Syntax-Check bei Google.
Strukturierte Daten sind das Fundament, auf dem Google Rich Results aufbaut und aus dem Sprachmodelle wie Perplexity oder ChatGPT ihre Zitationen speisen. Dennoch schreibt kaum ein Entwickler oder SEO-Manager tausende Zeilen verschachtelten JSON-LD-Code von Hand. Die manuelle Syntaxerstellung ist fehleranfällig, zeitraubend und bei komplexen Attributen unübersichtlich.
Aus diesem Grund gehört ein zuverlässiger Schema Markup Generator (auch JSON-LD Generator oder Schema Generator genannt) zur festen Grundausstattung jeder technischen SEO-Werkzeugkiste. Doch zwischen den weit verbreiteten Generatoren der ersten Generation und den Anforderungen moderner generativer Suchmaschinen klafft eine gewaltige Lücke. Wer blindlings Standard-Snippets in sein CMS kopiert, erzeugt häufig das Gegenteil von semantischer Klarheit: unverbundene Datenfragmente, die Crawler verwirren und die maschinelle Vertrauensbildung sabotieren.
Die fatale Schwachstelle klassischer Schema-Generatoren
Praktisch jeder Webmaster kennt die gängigen Online-Generatoren. Man wählt in einem Dropdown-Menü einen Typen wie LocalBusiness, Organization, Article oder Product aus, tippt Name, Adresse oder Preis in die Eingabemasken und erhält am Ende ein fertiges <script type="application/ld+json">-Tag.
Das Problem an dieser Vorgehensweise ist nicht die Syntax. Der erzeugte Code ist meist syntaktisch valide und besteht den Google Rich Results Test ohne Fehlermeldung. Die fundamentale Schwachstelle liegt in der Isolation:
Klassische Generatoren betrachten jede Entität als isolierte Insel. Wenn du für deine Startseite ein Snippet für dein Unternehmen generierst und auf derselben Seite über ein zweites Formular deine Dienstleistungen auszeichnest, erzeugst du zwei getrennte Datenblöcke. Für den Algorithmus von Google oder OpenAI existieren zwei Dinge nebeneinander: Ein Unternehmen irgendwo im Raum und eine Dienstleistung irgendwo im Raum. Die relationale Information – dass dieses spezifische Unternehmen der autorisierte Erbringer (provider) genau dieser Dienstleistung ist – geht vollständig verloren.
In der technischen Suchmaschinenoptimierung bezeichnen wir dieses Phänomen als Dateninseln. Sie senken den berechneten Confidence Score dramatischer als fehlende Attribute, weil Maschinen Widersprüche und Unklarheiten fürchten.

Jörg Zimmer
Senior SEO & AI Search Consultant
„Es gibt tausende SEO Tools, die die Arbeit der Suchmaschinenoptimierer nicht überflüssig machen. Sie zeigen dir nur die Möglichkeiten und erleichtern das Leben.“
Die Architektur moderner Entitäten-Generatoren: Der @graph-Standard
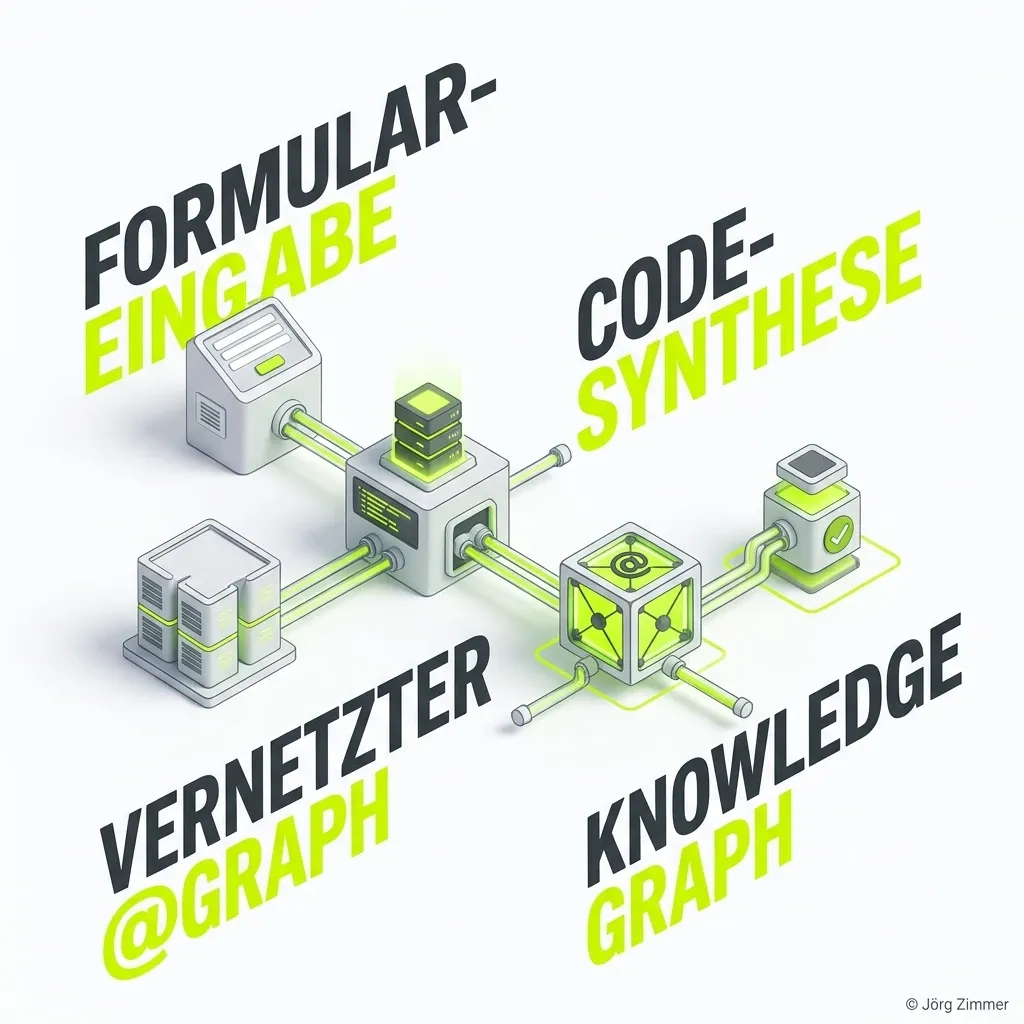
Ein zukunftssicherer Schema Markup Generator für das Jahr 2026 erzeugt keine Einzelschnipsel mehr. Er konstruiert einen zusammenhängenden Wissensgraphen.
Das technische Herzstück dieser Architektur ist das @graph-Array im JSON-LD. Anstatt fünf separate <script>-Tags im HTML-Header zu verteilen, bündelt ein professioneller Generator sämtliche Entitäten einer Website in einem einzigen Container. Die Verknüpfung der Knoten erfolgt über kanonische Fragment-Identifier (@id):
https://deinedomain.de/#persondeklariert den Gründer oder Experten.https://deinedomain.de/#organizationdeklariert die juristische Person des Unternehmens.https://deinedomain.de/#websiteverankert die Web-Präsenz.https://deinedomain.de/#serviceoder#productbeschreibt das konkrete Angebot.
Über relationale Eigenschaften schließt der Generator die Lücken:
Die Organisation referenziert die Person als founder. Die WebSite verweist auf die Organisation als publisher. Das Angebot verweist auf das Unternehmen als provider.
Für KI-Crawler und GraphRAG-Pipelines entsteht dadurch eine lückenlose semantische Landkarte. Das System muss keine Wahrscheinlichkeiten erraten, sondern liest ein mathematisch bewiesenes Netz aus Fakten und Beziehungen ab.
Kriterienvergleich: Welcher Generator-Typ löst deine Aufgabe?
Die folgende Übersicht stellt die drei gängigen Ansätze der Schema-Generierung gegenüber:
| Kriterium | Klassischer Online-Generator (z. B. Merkle / JSONLD.com) | Manuelles Coden im Texteditor | Moderner Entitäten-Graph-Generator |
|---|---|---|---|
| Ausgabe-Format | Isolierte Einzelschnipsel pro Typ | Beliebig gestaltbar, hohe Fehlerquote | Monolithischer @graph-Container |
| Vermeidung von Dateninseln | ❌ Nein (erzeugt unverbundene Inseln) | ⚠️ Nur bei extremem Expertenwissen | ✅ Vollautomatisch über @id-Referenzen |
| Entity Grounding (Wikidata) | ❌ Selten bis gar nicht vorhanden | ⚠️ Manuell aufwendig zu recherchieren | ✅ Integrierte sameAs-Verknüpfung |
| Archetypen-Unterstützung | Starre Typenauswahl | Volle Flexibilität, hoher Zeitaufwand | Branchenspezifisch (B2B, Shop, Handwerk) |
| Zeitaufwand pro Seite | 10 bis 20 Minuten pro Einzelschnipsel | Mehrere Stunden pro komplexem Setup | Unter 2 Minuten für den gesamten Graphen |
| Eignung für AI-SEO & LLMs | Mäßig (nur für klassische Rich Results) | Hoch (wenn fehlerfrei gepflegt) | Maximal (Zitations-Readiness 2026) |
Vorher-Nachher: Inselschnipsel versus vernetzter Wissensgraph
Um den technischen Unterschied plastisch zu machen, betrachten wir zwei Varianten desselben Unternehmens.
Die alte Methode: Fragmentierte Inselschnipsel (Fehlerhaft)
Hier werden zwei getrennte Script-Blöcke erzeugt. Die Suchmaschine weiß nicht, ob die Person und das Unternehmen zusammengehören:
<!-- Tag 1: Isolierte Person -->
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Person",
  "name": "Max Mustermann",
  "jobTitle": "Geschäftsführer"
}
</script>

<!-- Tag 2: Isolierte Organisation ohne Beziehung -->
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "Muster Bau GmbH",
  "url": "https://deinedomain.de"
}
</script>
Der 2026er Standard: Vernetzter @graph mit Relationen (Korrekt)
Ein moderner Generator erzeugt einen einzigen kohärenten Wissensknoten. Alle Entitäten besitzen eindeutige IDs und verweisen aufeinander:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Person",
      "@id": "https://deinedomain.de/#person",
      "name": "Max Mustermann",
      "jobTitle": "Geschäftsführer",
      "sameAs": [
        "https://www.linkedin.com/in/dein-profil/",
        "https://www.wikidata.org/wiki/Q12345"
      ]
    },
    {
      "@type": "Organization",
      "@id": "https://deinedomain.de/#organization",
      "name": "Muster Bau GmbH",
      "url": "https://deinedomain.de",
      "founder": {
        "@id": "https://deinedomain.de/#person"
      }
    },
    {
      "@type": "WebSite",
      "@id": "https://deinedomain.de/#website",
      "url": "https://deinedomain.de",
      "publisher": {
        "@id": "https://deinedomain.de/#organization"
      }
    }
  ]
}
</script>
Im zweiten Beispiel versteht jeder Crawler in Millisekunden: Max Mustermann ist der Gründer der Muster Bau GmbH, und die Muster Bau GmbH ist der offizielle Herausgeber dieser WebSite.
Die Kern-Bausteine: Welche Klassen ein moderner Generator beherrschen muss
Ein praxistauglicher Schema Generator darf sich nicht auf triviale Basisfelder beschränken. Um im maschinellen Entity SEO maximale Relevanz aufzubauen, muss das Werkzeug die wichtigsten Entitätsklassen des Schema.org-Vokabulars nahtlos miteinander verweben:
1. Die Unternehmens-Entität (Organization & LocalBusiness)
Die juristische Person bildet den Dreh- und Angelpunkt jeder Domain. Neben Basisdaten wie name, legalName und url verlangen moderne Answer Engines harte Verankerungsmerkmale:
address(PostalAddress): Kanonische Strukturierung nach Straße, Postleitzahl, Ort und Ländercode (addressCountry: "DE").geo(GeoCoordinates): Exakte Geokoordinaten mit Breitengrad (latitude) und Längengrad (longitude), um lokale Verwechslungen im Kartenmaterial auszuschließen.vatID&identifier: Offizielle Handelsregisternummern oder Umsatzsteuer-Identifikationsnummern schaffen maximale Verifizierbarkeit.openingHoursSpecification: Strukturierte Geschäftszeiten mit Wochentagen, Öffnungs- und Schließzeiten.
2. Die Experten-Entität (Person)
Im Zeitalter von E-E-A-T und generativer Suche akzeptiert Google keine anonymen Texte mehr. Der Generator muss Urheber lückenlos abbilden:
knowsAbout: Konkrete Themengebiete und Fachdisziplinen, idealerweise mit Wikidata-Verlinkung (z. B. Suchmaschinenoptimierung viahttps://www.wikidata.org/wiki/Q180711).hasOccupation: Standardisierte Berufsklassifikationen nach ISCO-08 oder Berufsbezeichnungen.alumniOf: Akademische Abschlüsse, Universitäten oder Fachzertifikate.
3. Die Angebots- und Leistungs-Entität (Service, Product, Offer)
Monetäre Dienstleistungen und Produkte dürfen niemals als isolierte Landingpages existieren. Sie müssen relational an das Unternehmen gekoppelt sein:
provider: Rückverweis auf die Organization als autorisierter Erbringer.areaServed: Geografischer Aktionsradius (z. B. DACH-Region, Bundesland oder 50-km-Umkreis).offers(Offer): Preisspezifikationen, akzeptierte Währungen (EUR) und Verfügbarkeiten (InStock).hasMerchantReturnPolicy: Speziell für E-Commerce und Online-Shops verlangt Google seit 2024 verbindliche strukturierte Rückgaberichtlinien mit Rückgabefristen und Gebührenregeln.
4. Die Website-Entität (WebSite & WebPage)
Die WebSite deklariert die übergeordnete Plattform und verbindet den Quellcode mit internen Navigationsbäumen:
inLanguage: Primäre Sprachauszeichnung (de-DE), um Sprachmodellen die korrekte Lokalisierung zu signalisieren.potentialAction(SearchAction): Deklaration der internen Suchfunktion für Sitelinks Searchboxen in den Google SERPs.
Anatomie des Graph-Codes: Warum Fragment-URIs der Schlüssel sind
Der entscheidende Unterschied zwischen fehleranfälligem Code und professionellem Enterprise-Markup liegt in der Handhabung der Identifikatoren. Ein Blick auf die Funktionsweise von Knowledge Graph Triplestores verdeutlicht die Mechanik:
Graph-Datenbanken speichern Informationen nicht in Tabellen, sondern in sogenannten Tripeln: Subjekt → Prädikat → Objekt.
Wenn du ein Schema ohne @id schreibst, erzeugt der Parser sogenannte „Blind-Knoten“ (Blank Nodes). Ein Blank Node hat keine eindeutige Adresse. Möchte ein Sprachmodell nun eine Verknüpfung zwischen dem Autor eines Artikels und der Firma herstellen, scheitert der Vorgang, weil der Autor keinen maschinenlesbaren Bezeichner besitzt.
Durch den Einsatz von Fragment-URIs (https://deinedomain.de/#person) vergibt der Generator eine permanente, unveränderliche Speicheradresse. Jede andere Entität auf jeder beliebigen Unterseite der Website kann diesen Knoten über ein einfaches Objekt { "@id": "https://deinedomain.de/#person" } referenzieren. Das spart Ladezeit, verhindert Redundanzen und erzeugt ein unzerstörbares semantisches Netz.
Automatisierung: Schema-Generierung in moderne CI/CD-Pipelines einbinden
Wer hunderte oder tausende Seiten verwaltet, kann JSON-LD nicht manuell in HTML-Dateien kopieren. Moderne Entwicklungsteams binden die Generierungslogik direkt in ihre Template-Engines (Astro, Next.js, Nuxt, PHP oder Laravel) ein:
- Globale Basis-Entitäten (Layout-Ebene): Erstelle eine zentrale Komponente, die auf jeder Unterseite den unveränderlichen Kern rendert (WebSite, Organization, Founder).
- Dynamische Seiten-Entitäten (Page-Ebene): Ergänze auf Artikelebene lediglich die spezifischen Typen (
BlogPosting,ProductoderFAQPage) und verlinke sie überisPartOfoderauthormit den IDs des globalen Layouts. - Automatisierte Pre-Flight-Tests: Binde in deine GitHub Actions oder Deployment-Skripte einen automatisierten Validator ein. So wird verhindert, dass Syntaxfehler oder unvollständige Pflichtfelder den Livegang unbemerkt passieren.
Die 3 häufigsten Praxis-Fehler beim Einsatz von Schema-Generatoren
Trotz automatisierter Tools schleichen sich in Kundenprojekten immer wieder gravierende Fehler ein, die Rankings und KI-Sichtbarkeit kosten:
1. Doppelter Plugin-Wildwuchs im CMS
Viele WordPress- oder Shopify-Betreiber installieren ein SEO-Plugin (wie Yoast oder Rank Math), parallel ein Bewertungs-Plugin und zusätzlich ein lokales Business-Plugin. Jedes dieser Tools bringt seinen eigenen rudimentären Generator mit. Das Resultat im DOM-Tree: Vier verschiedene @context-Aufrufe und konkurrierende Unternehmensdeklarationen. Deaktiviere redundante Schema-Ausgaben im CMS und nutze stattdessen eine zentrale Vorlage.
2. Autorenschaft als reiner Textstring statt Entität
Wenn Generatoren Blogartikel (BlogPosting) auszeichnen, tragen viele Nutzer in das Feld author lediglich einen einfachen Textnamen ein ("author": "Max Mustermann"). Für moderne Antwortmaschinen ist ein Name ohne @id wertlos. Verknüpfe den Autor zwingend als echtes Person-Objekt mit biografischer Verlinkung und Expertise-Nachweisen (knowsAbout).
3. Fehlende Content Parity (Ghost Schema)
Ein Schema Generator verführt dazu, Eigenschaften auszufüllen, die im eigentlichen Webseitentext gar nicht vorkommen – beispielsweise Servicepreise, Öffnungszeiten oder Auszeichnungen. Weichen die Schema-Daten vom für den menschlichen Besucher sichtbaren HTML ab, schlagen Googles Algorithmen gnadenlos zu: Das Markup wird als Täuschungsversuch eingestuft und vollständig entwertet.
So erstellst du deinen perfekten Graph-Code in der Praxis
Um den Übergang von isolierten Schnipseln zu einem echten Knowledge Graph zu meistern, steht dir auf dieser Plattform eine kostenlose Suite spezialisierter Werkzeuge zur Verfügung:
- Code generieren: Nutze unseren interaktiven Entitäten-Graph-Generator. Wähle deinen passenden Branchen-Archetypen (Freiberufler, Handwerksbetrieb, B2B-Dienstleister, Online-Shop oder Praxis) und trage deine Grunddaten ein. Der Generator verknüpft Personen, Organisationen, Angebote und Webseiten automatisch in einem validierten
@graph-Container. - Qualität prüfen & visualisieren: Nach dem Einbinden in deinen HTML-Header prüfst du deine Domain im Schema-Graph-Visualizer. Das Tool fungiert als Dateninseln-Radar: Es deckt unverbundene Knoten auf, berechnet deinen 3-Ebenen Entity Health Score und vergleicht deinen Ist-Zustand mit dem optimalen Soll-Graphen.
- Auditieren & Monitoren: Um sicherzustellen, dass keine Serverprobleme oder Skriptblockaden die Auslesbarkeit behindern, empfiehlt sich ein regelmäßiges Site-Audit mit SE Ranking (Partnerlink). Wer zusätzlich nachweisen will, wie stark generative Sprachmodelle die erzeugten Entitäten zitierten, greift auf das KI-Monitoring von Rankscale (Partnerlink) zurück.
Mit dieser Kombination verwandelst du unstrukturierte Webseiten in mathematisch saubere Wissensquellen, die in klassischen Google-Ergebnissen ebenso wie in generativen KI-Antworten als unverzichtbare Autorität wahrgenommen werden.
Deinen Schema.org Graph live im Visualizer prüfen
Erkenne isolierte Dateninseln, prüfe deinen 3-Ebenen Entity Health Score und teste, wie Suchmaschinen und KI-Modelle deinen Wissensgraphen wahrnehmen.
Jetzt an der Diskussion teilnehmen
Diskutiere mit Jörg Zimmer und der SEO-Community auf LinkedIn über Schema Markup Generatoren, Dateninseln und vernetzte Knowledge Graphs.
Jörg Zimmer auf LinkedIn kontaktierenWas unterscheidet einen modernen Schema Markup Generator von alten Standard-Tools?
Warum führen mehrere getrennte JSON-LD Snippets zu Problemen in der KI-Suche?
Welche technischen Eigenschaften muss valider JSON-LD Code 2026 aufweisen?
Wie teste ich generiertes Schema Markup auf Fehler und Vollständigkeit?
Weitere spannende Themen
- Technisches Schema-Markup für KI & SEO
- Schema.org Markup: Fakten-Wissensbasis für KIs
- HTML-Struktur: Semantik für KI-Crawler & RAG
- RFC 8288 Link Headers: HTTP für KI-Crawler
- XML-Sitemap: Die Zentrale für KI und Crawler
- Google Knowledge Graph Search API: Entitäten-Abfrage
- Open Graph: Protokoll, OG-Tags & Social Previews im Detail
ℹ️ Transparenz-Hinweis zu Partnerlinks
Einige Links in diesem Beitrag sind sogenannte Partnerlinks (mit einem Sternchen * oder als solche gekennzeichnet). Wenn du über einen dieser Links ein Tool buchst oder testest, erhalte ich gegebenenfalls eine kleine Provision. Der Preis für dich bleibt exakt derselbe – du unterstützt damit meine unabhängigen Tests und Praxisberichte.
Nichts mehr verpassen?
Folge mir auf LinkedIn für tägliche SEO-Nuggets und diskutiere mit anderen Experten.
LinkedIn-Profil besuchen →