Erstellt: 11. März 2026 • Zuletzt aktualisiert: 17. September 2026
Semantische Suche: Vektoren & Entitäten statt Keywords
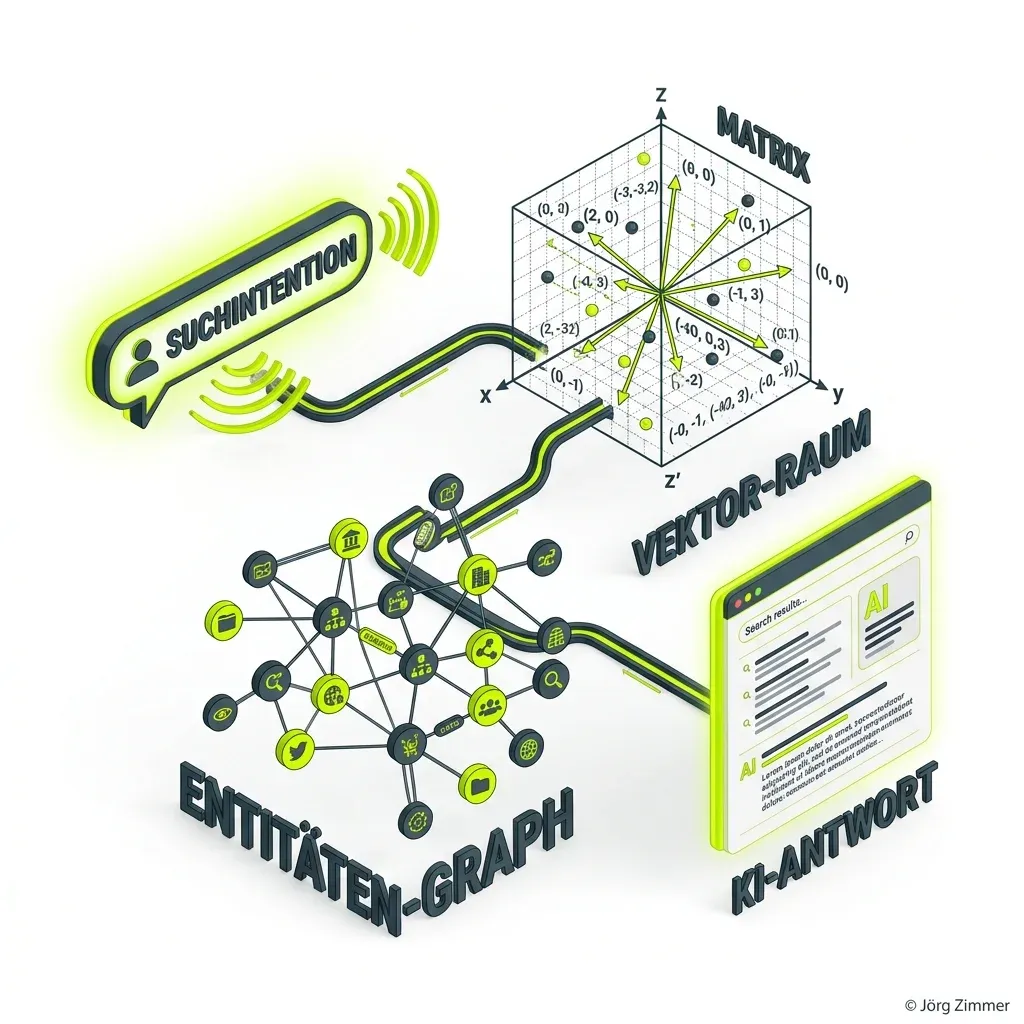
Wichtigste Erkenntnisse
- Semantische Suche analysiert nicht bloße Buchstabenfolgen (Strings), sondern die tiefere Bedeutung (Semantik) und Absicht hinter einer Suchanfrage.
- Durch Vektoreinbettungen (Embeddings) werden Wörter und Konzepte in mehrdimensionale mathematische Räume übersetzt.
- Der Knowledge Graph verknüpft Entitäten über feste Attribute und ermöglicht logische Schlüsse über Wissensgrenzen hinweg.
- Modernes SEO erfordert den Aufbau thematischer Autorität (Topical Authority) und saubere maschinenlesbare Schemas statt Keyword-Dichte.
Was ist semantische Suche?
Die semantische Suche (Semantic Search) bezeichnet die Fähigkeit moderner Suchmaschinen und KI-Systeme, nicht nur die buchstäblichen Zeichenketten einer Suchanfrage abzugleichen, sondern deren wahre Bedeutung, den Kontext und die zugrundeliegende Suchintention (Search Intent) präzise zu interpretieren.
Während die frühe Suchmaschinentechnologie auf starrer Keyword-Dichte und dem Vorkommen exakter Textphrasen basierte, operieren moderne Algorithmen wie Google Hummingbird, RankBrain oder moderne LLMs im semantischen Vektorraum. Sie begreifen die Welt als Gefüge vernetzter Entitäten – real existierende Objekte, Personen, Organisationen und Konzepte – die in logischen Beziehungen zueinander stehen.

Jörg Zimmer
Senior SEO & AI Search Consultant
„SEO ist auch Architektur und Management.“
Die drei Säulen der semantischen Sucharchitektur
Damit ein Algorithmus Bedeutung erfassen kann, greifen drei Kerntechnologien ineinander:
+---------------------+         +---------------------+         +---------------------+
|   1. Vektor-Raum    |         | 2. Knowledge Graph  |         |  3. Answer Engine   |
|     (Embeddings)    | ------> |    (Faktenbasis)    | ------> |     (Synthese)      |
+---------------------+         +---------------------+         +---------------------+
  Mathematische Nähe              Strukturierte Relationen        Kontextuelle Antwort
  von Begriffen im Raum          über Wikidata & Entities        mit Confidence Score
1. Vektoreinbettungen (Embeddings)
Wörter, Sätze und ganze Webseiten werden durch Deep-Learning-Modelle in hochdimensionale Vektoren (Zahlenreihen) transformiert. Begriffe mit ähnlichem Sinngehalt (wie „Laufschuh“ und „Jogging-Sneaker“) besitzen im Vektorraum eine minimale mathematische Distanz (Cosine Similarity). Dadurch versteht das System, dass ein Nutzer, der nach „günstige Laufschuhe für Marathon“ sucht, auch mit Inhalten über „Wettkampfschuhe mit Dämpfung“ bedient werden kann.
2. Der Wissensgraph (Knowledge Graph)
Während Vektoren statistische Wahrscheinlichkeiten abbilden, speichert der Knowledge Graph feste, verifizierte Fakten. Er weiß, dass „Berlin“ die Hauptstadt von „Deutschland“ ist und dass das Brandenburger Tor eine Sehenswürdigkeit in dieser Stadt darstellt. Primäre externe Quellen wie Wikidata SEO füttern diese Graphen kontinuierlich mit strukturiertem Wissen.
3. Entity Disambiguation (Kontextauflösung)
Sucht jemand nach dem Begriff „Jaguar“, entscheidet der semantische Kontext der Session (z. B. vorherige Suchanfragen nach PS-Zahlen oder Tierparks), ob das Google Knowledge Panel für den Automobilhersteller oder das Raubtier ausgespielt wird.
Warum klassisches Keyword-SEO in der semantischen Ära versagt
Im klassischen SEO galt die Faustformel: Je exakter und häufiger ein Keyword im Text platziert wird, desto besser das Ranking. In der semantischen Suche führt dieser Ansatz ins Abseits:
| Klassisches Keyword-SEO (Veraltet) | Semantisches Entitäten-SEO (Modern) |
|---|---|
| Fokus auf Keyword-Dichte (TF-IDF, WDF*IDF). | Fokus auf Entitäten-Abdeckung und semantische Relationen. |
| Eine Einzelseite pro Keyword-Variation. | Ganzheitliche Themen-Hubs mit umfassender Topical Authority. |
| Flacher Text ohne maschinenlesbare Meta-Ebene. | Tiefe Strukturierung via Schema.org Markup und JSON-LD. |
| Beliebige Backlinks von irrelevanten Seiten. | Co-Occurrences in autoritativen Fachpublikationen. |
Wenn generative Answer Engines (Google AI Overviews, Perplexity, ChatGPT Search) Antworten synthetisieren, bewerten sie Inhalte nach ihrem Confidence Score. Nur Dokumente, deren Entitäten logisch widerspruchsfrei mit der Ground Truth des Netzes harmonieren, werden als Primärquelle zitiert.
Praktische Umsetzung: Website semantisch optimieren
Wer im semantischen Web dominieren will, muss seine Website als Wissensknoten aufbauen:
- Themen-Cluster statt Silo-Seiten: Baue Pillar Pages, die ein Kernthema in die Tiefe behandeln, und verlinke logisch verwandte Subthemen.
- Entitäten-Verknüpfung via JSON-LD: Verbinde deine Autoren, dein Unternehmen und deine Produkte maschinenlesbar. Nutze das
sameAs-Attribut, um auf Wikidata, Wikipedia oder LinkedIn zu referenzieren. - Konfliktfreie Graph-Architektur: Vermeide isolierte Schema-Snippets. Nutze einen Schema Markup Generator oder erstelle vernetzte JSON-LD-Container mit unserem Entitäten Graph Generator.
- Visuelle Validierung: Kontrolliere deinen Entitäten-Graphen im Schema Graph Visualizer, um verwaiste Knoten und Dateninseln zu eliminieren.
Die offizielle Agentenbox: Semantisches Entity-Clustering für Coding-Assistenten
Arbeitsanweisung für deinen KI-Agenten (Cursor / Claude / Antigravity)
Kopiere diesen Prompt direkt in deinen KI-Coding-Assistenten, um die semantische Informationsarchitektur und Entitäten-Verknüpfung für dein Projekt umzusetzen:
# Prompt: Semantische Entitäten-Architektur
Rolle: Du bist ein erfahrener Information Architect und Semantic Web Engineer.
Aufgabe: Analysiere die bestehende Seitenstruktur und erarbeite ein semantisches Themen-Cluster mit relationalem Schema.org JSON-LD Markup, das Haupt- und Nebenentitäten widerspruchsfrei verbindet.
# Vorgehensweise & Sicherheitsregeln:
1. Tech-Stack-Analyse: Untersuche Framework/CMS und identifiziere alle vorhandenen Metadaten- und Schema-Strukturen.
2. Defensive Integration: Baue ein modulares @graph-Schema auf, das Article, Author (Person) und Publisher (Organization) über persistente @id-URIs verknüpft. Überschreibe keine Core-Stile oder bestehende Tracking-Scripte.
3. Standard- & URL-Hygiene: Verwende einheitliche Trailing Slashes, absolute HTTPS-URLs und verifizierte sameAs-Links zu relevanten Entitätsquellen.
4. Pre-Flight-Validierung: Überprüfe das Markup auf Validität im Schema Markup Validator und stelle sicher, dass keine verwaisten Knoten ohne Kantenbeziehung existieren.
Output: 1. Themen-Cluster-Übersicht, 2. Relationaler JSON-LD @graph Code, 3. Prüfbericht für semantische Konsistenz.
Jetzt an der Diskussion teilnehmen
Diskutiere mit Jörg Zimmer und der SEO-Community auf LinkedIn über semantische Suche, Vektoren und Entity SEO.
Beitrag auf LinkedIn öffnenWas ist der Unterschied zwischen lexikalischer und semantischer Suche?
Welche Meilensteine führten bei Google zur semantischen Suche?
Wie optimiert man Webseiten für semantische Suchsysteme?
Welche Rolle spielen Vektoren in der semantischen Suche?
Weitere spannende Themen
- Was ist ein Promptset? Aufbau & Strategie
- Share of Model (SoM): Die zentrale KI-Sichtbarkeits-KPI
- SOVP Protocol: Determinismus in KI-Infrastrukturen
- Wenn AI-Agenten deinen LinkedIn-Feed kapern
- Mein geheimer Mega-Prompt für SEO in Claude
- KI-generierte Website Kennzeichnungspflicht?
- Meine KI-Website Auf dem Weg zum Leuchtturm für Agenten
Nichts mehr verpassen?
Folge mir auf LinkedIn für tägliche SEO-Nuggets und diskutiere mit anderen Experten.
LinkedIn-Profil besuchen →