Erstellt: 11. März 2026 • Zuletzt aktualisiert: 19. September 2026
Semantic Web: Linked Data & Web 3.0 für AI Search
Wichtigste Erkenntnisse
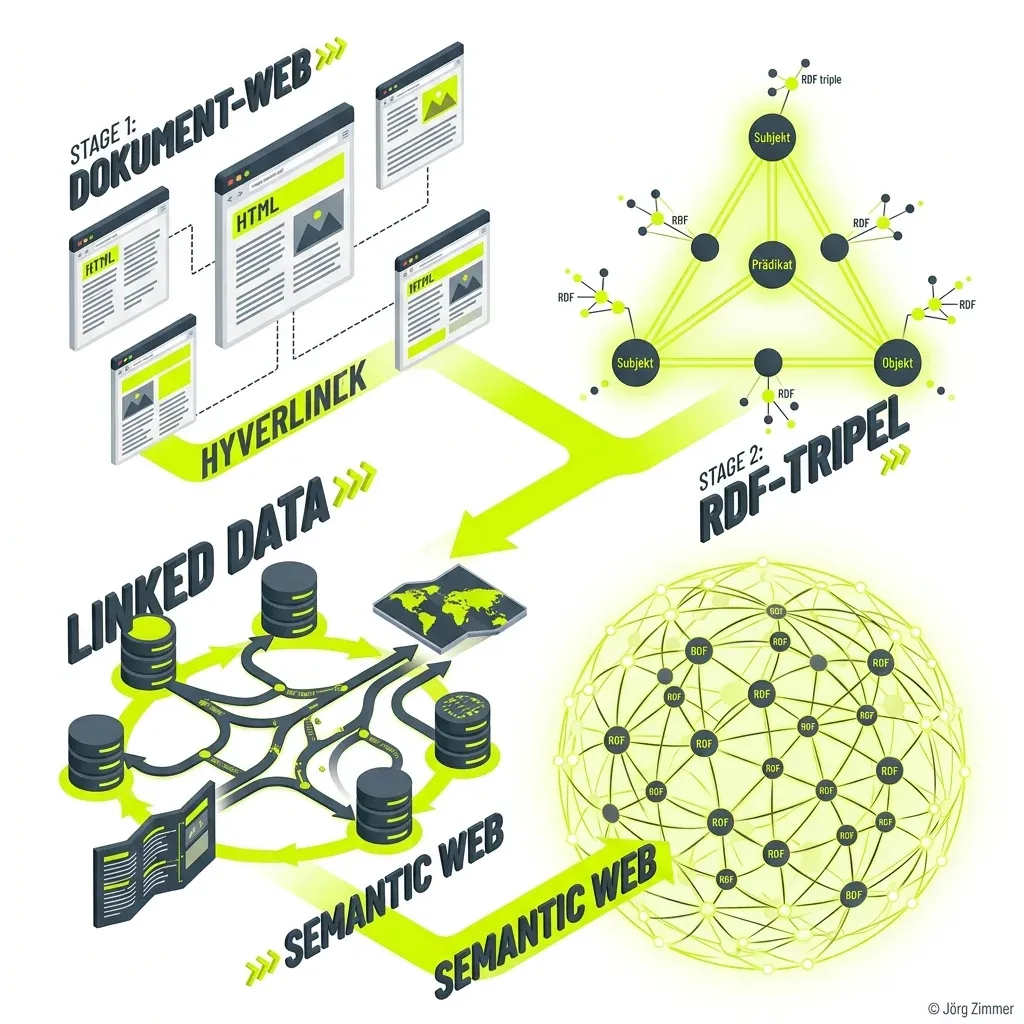
- Das Semantic Web erweitert das traditionelle Dokumenten-Web um eine universelle, maschinenlesbare Datenebene (Web of Data).
- Informationen werden in RDF-Tripeln (Subjekt – Prädikat – Objekt) strukturiert und über weltweite URIs eindeutig adressiert.
- Linked Data verbindet isolierte Datenbanken über das sameAs-Attribut zu einem globalen, abfragbaren Wissensgraphen.
- JSON-LD und Schema.org machen die Prinzipien des Semantic Web für moderne SEO-Pipelines und KI-Agenten pragmatisch nutzbar.
Was ist das Semantic Web?
Das Semantic Web (semantisches Web) bezeichnet die Erweiterung des klassischen World Wide Web um eine strukturierte, maschinenlesbare Bedeutungsebene. Während das ursprüngliche Web von Tim Berners-Lee primär als ein „Netz aus Dokumenten“ (Web of Documents) für menschliche Augen konzipiert war, transformiert das Semantic Web das Internet in ein globales, vernetztes Datenbanksystem (Web of Data).
Im Zentrum steht die Idee, dass Computerprogramme, Suchmaschinen-Crawler und autonome KI-Agenten die Inhalte einer Webseite nicht nur als bloße Pixel oder Textzeichenketten darstellen, sondern deren semantischen Sinn und logische Zusammenhänge verstehen können.
Für das moderne SEO und die semantische Suche markiert das Semantic Web das theoretische und technologische Fundament: Erst durch standardisierte semantische Datenstrukturen wie Schema.org Markup und Linked Data ist Google in der Lage, Entitäten zu erfassen und einen weltweiten Knowledge Graph aufzubauen.

Jörg Zimmer
Senior SEO & AI Search Consultant
„Wenn wir von Anfang an an alle Aspekte denken, können wir sicherstellen, dass unsere Websites nicht nur schön aussehen, sondern auch technisch optimal aufgestellt sind, um im Wettbewerb um die Spitzenpositionen in den Suchergebnissen erfolgreich zu sein.“
Jörgs Praxistipp aus der SEO-Sprechstunde
Das Semantic Web ist keine akademische Theorie mehr, sondern die Voraussetzung für KI-Zitationen: Wenn deine Website nur als Fließtext existiert, müssen Sprachmodelle Bedeutung und Relationen mühsam erraten. Gib deinen Daten eine maschinenlesbare Syntax: Verknüpfe Personen, Produkte und Dienstleistungen im Quellcode per JSON-LD über @graph, damit Suchmaschinen und KI-Agenten deine Entitäten ohne Parsing-Fehler verarbeiten.
Kontrollfrage an deine Webagentur: „Nutzen wir im Quellcode verknüpfte Linked-Data-Strukturen mit eindeutigen URIs und Schema.org-Typen, um unsere Entitäten als Knoten im Web of Data zu positionieren?“
🚦 Praxis-Ampel: Semantic Web & Linked Data
Eindeutige URIs (@id) für Entitäten vergeben, Aussagen in logischen RDF-Tripeln modellieren und mit Wikidata sowie dem Open Knowledge Graph vernetzen.
Isolierte Microdata-Attribute im HTML verstreuen: Schwerer zu warten als ein zentrales, valides JSON-LD Script im Kopfbereich und anfällig für DOM-Syntaxfehler.
Reines Text-HTML ohne jegliche semantische Auszeichnung: Zwingt KI-Crawler zu fehleranfälligem Heuristik-Parsing in ChatGPT SEO und Bing SEO.
Die 4 Säulen der semantischen Architektur
Damit aus getrennten Textdateien ein intelligentes Wissensnetzwerk entsteht, stützt sich das Semantic Web auf vier international standardisierte W3C-Technologien:
+-------------------------------------------------------------------------+
|                  4. Ontologien & Vokabulare (Schema.org / OWL)           |
+-------------------------------------------------------------------------+
                                     │
                                     ▼
+-------------------------------------------------------------------------+
|                  3. Linked Data Syntax (JSON-LD / Turtle)               |
+-------------------------------------------------------------------------+
                                     │
                                     ▼
+-------------------------------------------------------------------------+
|                  2. Datenmodell: RDF Triples (Subjekt - Prädikat - Objekt)|
+-------------------------------------------------------------------------+
                                     │
                                     ▼
+-------------------------------------------------------------------------+
|                  1. Eindeutige Identifier: URIs / IRIs                  |
+-------------------------------------------------------------------------+
1. URIs (Uniform Resource Identifiers)
Jede Entität im semantischen Netz – sei es ein Mensch, ein Buch, ein Ort oder ein Unternehmen – erhält eine weltweit eindeutige URI. Anstelle des mehrdeutigen Namens „Jörg Zimmer“ referenziert der Algorithmus die persistente Adresse https://teleschmie.de/#person.
2. RDF-Tripel (Resource Description Framework)
Wissen wird in atomaren Dreierschritten formuliert:
- Subjekt: Die Entität, über die etwas ausgesagt wird (
https://teleschmie.de/#person) - Prädikat: Die Eigenschaft oder Beziehung (
founder) - Objekt: Der Zielwert oder eine andere Entität (
https://teleschmie.de/#localbusiness)
3. Linked Data Prinzipien
Daten dürfen nicht in isolierten Silos liegen. Nach den vier Linked-Data-Prinzipien von Tim Berners-Lee müssen Entitäten über das sameAs-Attribut mit externen Autoritäts-Hubs wie Wikidata SEO verknüpft sein.
4. Formale Ontologien
Eine SEO Ontologie definiert die logischen Spielregeln: Welche Eigenschaften darf eine Klasse besitzen und welche Folgerungen (Inferenz) dürfen KIs daraus ableiten?
Von der Theorie zur Praxis: Warum JSON-LD den Durchbruch brachte
Jahrelang galt das Semantic Web als akademischer Elfenbeinturm, weil die ursprünglichen Formate (XML/RDF) für Webentwickler zu sperrig waren. Der weltweite Durchbruch im praktischen Entitäten SEO gelang erst durch zwei Meilensteine:
- Schema.org: Die Einigung der führenden Suchmaschinen auf ein praxisnahes, pragmatisches Vokabular.
- JSON-LD (Linked Data in JSON): Die Trennung von sichtbarem HTML und maschinenlesbarem Daten-Graph. Entwickler können strukturierte Daten als sauberen Script-Block im Header platzieren, ohne das visuelle CSS-Layout anzutasten.
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Person",
      "@id": "https://example.de/#expert",
      "name": "Alex Schmidt",
      "sameAs": "https://www.wikidata.org/wiki/Q12345"
    },
    {
      "@type": "Organization",
      "@id": "https://example.de/#company",
      "name": "Semantics GmbH",
      "founder": { "@id": "https://example.de/#expert" }
    }
  ]
}
</script>
Das Problem der Dateninseln und wie du es löst
Obwohl das Semantic Web auf Vernetzung beruht, produzieren viele Content-Management-Systeme (WordPress, Shopify) unvollständiges Markup: Mehrere Plugins injizieren isolierte JSON-LD-Schnipsel ohne @id-Kanten. Für Suchmaschinen existieren diese Daten nebeneinander als unzusammenhängende Dateninseln.
Wer im Zeitalter generativer KI-Suche maximale Sichtbarkeit und verlässliches AI Grounding erreichen will, muss seine Ontologie lückenlos verbinden.
Mit unserem kostenlosen Entitäten Graph Generator erstellst du monolithischen @graph-Code nach modernsten Linked-Data-Standards. Die visuelle Überprüfung deines Wissensgraphen gelingt in Sekundenschnelle im interaktiven Schema Graph Visualizer.
Deinen Linked Data Graph live im Visualizer prüfen
Erkenne isolierte Dateninseln, prüfe deine RDF-Verknüpfungen und teste deinen 3-Ebenen Entity Health Score direkt im interaktiven D3-Graphen.
Die offizielle Agentenbox: Linked-Data-Audit für KI-Coding-Assistenten
Arbeitsanweisung für deinen KI-Agenten (Cursor / Claude / Antigravity)
Kopiere diesen Prompt direkt in deinen KI-Coding-Assistenten, um die Linked-Data-Struktur deiner Website auf W3C- und Schema.org-Konformität zu auditieren:
# Prompt: Linked Data & Semantic Web Audit
Rolle: Du bist ein hochqualifizierter Semantic Web Engineer und Linked Data Architekt.
Aufgabe: Überprüfe das HTML-Markup auf Einhaltung der Linked Data Prinzipien. Konsolidiere getrennte Schema-Blöcke in ein zusammenhängendes RDF/JSON-LD Modell mit kanonischen URIs und sameAs-Verknüpfungen.
# Vorgehensweise & Sicherheitsregeln:
1. Tech-Stack-Analyse: Prüfe Webserver, CMS und vorhandene Skripte auf mehrfache @context-Definitionen und isolierte Dateninseln.
2. Defensive Integration: Führe alle Daten in einem monolithischen @graph-Array zusammen. Stelle sicher, dass Relationen (author, publisher, provider) auf gültige interne @id-Knoten verweisen.
3. Standard- & URL-Hygiene: Nutze absolute HTTPS-URIs für alle Identifikatoren. Binde externe Autoritäts-URIs (Wikidata, VIAF, GND) über sameAs ein.
4. Pre-Flight-Validierung: Teste das Markup im Schema Validator und Google Rich Results Test auf strukturelle Fehlerfreiheit.
Output: 1. Befund der RDF-Beziehungsanalyse, 2. Fehlerfreier JSON-LD Code-Diff, 3. Prüfprotokoll für Dateninseln.
Jetzt an der Diskussion teilnehmen
Diskutiere mit Jörg Zimmer und der SEO-Community auf LinkedIn über Semantic Web, Linked Data und die Evolution der KI-Suche.
Beitrag auf LinkedIn öffnenWas ist das Semantic Web einfach erklärt?
Wer hat das Semantic Web erfunden?
Was ist der Unterschied zwischen RDF und JSON-LD?
Warum erlebt das Semantic Web durch KI und LLMs ein Comeback?
Weitere spannende Themen
- Semantic SEO: Themenwelten im Vektorraum steuern
- KI SEO: Klassisches SEO vs. künstliche Intelligenz
- OAuth Protected Resource im A2A-Zeitalter
- Ontologie im SEO: Semantische Datenmodelle für KI
- Semantische Suche: Vektoren & Entitäten statt Keywords
- Was ist ein Promptset? Aufbau & Strategie
- Share of Model (SoM): Die zentrale KI-Sichtbarkeits-KPI
Nichts mehr verpassen?
Folge mir auf LinkedIn für tägliche SEO-Nuggets und diskutiere mit anderen Experten.
LinkedIn-Profil besuchen →