Erstellt: 11. März 2026 • Zuletzt aktualisiert: 17. September 2026
Ontologie im SEO: Semantische Datenmodelle für KI
Wichtigste Erkenntnisse
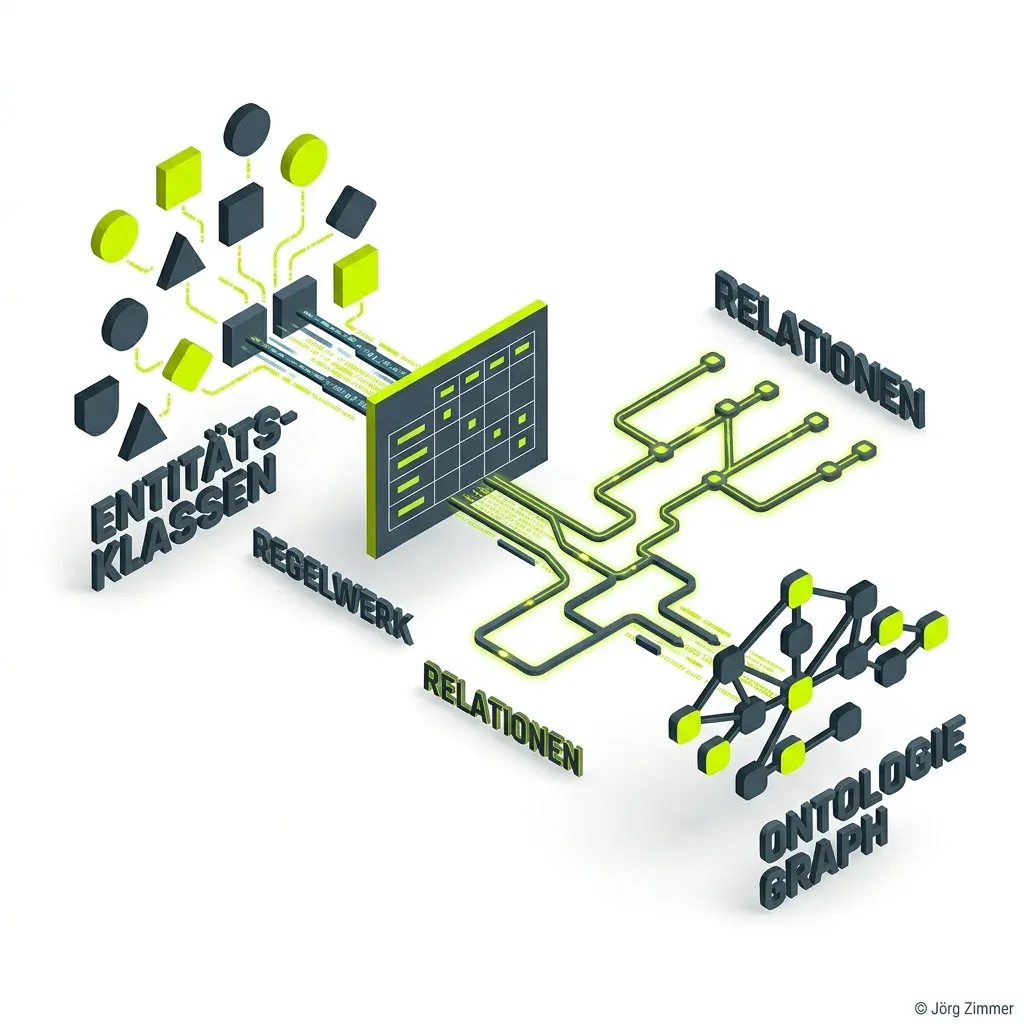
- Eine Ontologie ist der formale Bauplan eines Wissensgebiets und definiert Klassen, Attribute sowie zulässige Relationen zwischen Entitäten.
- Während ein Knowledge Graph die konkreten Fakten speichert, liefert die Ontologie das strukturelle Regelwerk für KI-Suchmaschinen.
- Schema.org fungiert im Web als die universell anerkannte Standard-Ontologie für Suchmaschinen, Answer Engines und autonome Agenten.
- Eine saubere Ontologie-Architektur verhindert Dateninseln und sichert die fehlerfreie logische Verknüpfung im JSON-LD Graph-Code.
Was ist eine Ontologie und warum ist sie das Rückgrat moderner Suchmaschinen?
In der Philosophie bezeichnet die Ontologie die Lehre vom Sein und den Grundstrukturen der Wirklichkeit. In der Informatik, im Semantic Web und in der modernen Suchmaschinenoptimierung hat der Begriff eine präzise technische Bedeutung: Eine Ontologie ist ein formales, maschinenlesbares Regelwerk, das festlegt, welche Klassen von Objekten existieren, welche Eigenschaften (Attribute) sie besitzen und wie sie in Beziehung zueinander stehen dürfen.
Wenn Google oder KI-Answer-Engines (Perplexity, ChatGPT, Gemini) das Web durchsuchen, begnügen sie sich nicht mit isolierten Zeichenfolgen. Sie benötigen ein semantisches Datenmodell, um zu verstehen, was ein Dokument aussagt.
- Eine Entität ist das konkrete Objekt (z. B. „Jörg Zimmer“).
- Der Knowledge Graph ist die Wissensdatenbank, die all diese Objekte und Fakten speichert.
- Die Ontologie ist die übergeordnete Architektur-Grammatik, die definiert: „Eine Person kann Autor einer WebPage und Gründer einer Organization sein.“

Jörg Zimmer
Senior SEO & AI Search Consultant
„SEO ist auch Architektur und Management.“
Schema.org als die globale Web-Ontologie
Um einen weltweiten Standard für das semantische Web zu schaffen, gründeten Google, Microsoft, Yahoo und Yandex im Jahr 2011 die Initiative Schema.org. Schema.org ist nichts anderes als eine universelle, offene Ontologie für das Internet.
Sie stellt ein hierarchisches Vokabular zur Verfügung:
Thing (Das universelle Stamm-Objekt)
 ├── Person (Name, jobTitle, knowsAbout, sameAs)
 ├── Organization (legalName, founder, address, logo, sameAs)
 │    └── LocalBusiness (openingHours, priceRange, geo)
 ├── CreativeWork (headline, author, publisher, inLanguage)
 │    ├── WebSite (potentialAction, publisher)
 │    └── Article / BlogPosting (articleBody, about, mentions)
 └── Product (name, offers, aggregateRating, brand)
Werden Daten auf einer Website ohne ontologisches Verständnis implementiert, entstehen unverbundene Fragmente: Ein Skript-Tag deklariert ein Produkt, ein zweiter die Firma, ein dritter den Autor. Weil die verbindenden Kanten fehlen, weiß der Crawler nicht, dass der Autor bei der Firma arbeitet oder dass die Firma das Produkt herstellt. Es entstehen isolierte Dateninseln.
Ontologie V2: Die Evolution vernetzter Graph-Architekturen
Moderne semantische Modellierung – wie sie in fortschrittlichen Generatoren und im Entitäten SEO praktiziert wird – folgt dem Ontologie-V2-Prinzip. Statt loser Snippets wird ein relationaler @graph-Container im JSON-LD-Format aufgebaut:
+-------------------------------------------------------------------------+
|                    Schema.org Monolithischer @graph                     |
+-------------------------------------------------------------------------+
|  [Organization #org] <========= founder ========= [Person #founder]   |
|         │                                                 │             |
|     publisher                                          author           |
|         │                                                 │             |
|         ▼                                                 ▼             |
|  [WebSite #site] <------------ isPartOf ------------ [WebPage #page]    |
|                                                           │             |
|                                                        mentions         |
|                                                           ▼             |
|                                                   [Wikidata Q-ID]       |
+-------------------------------------------------------------------------+
Die 3 Kernregeln der Ontologie V2:
- Monolithischer Container: Alle Entitäten einer URL werden in einem einzigen JSON-LD
@graph-Array deklariert. - Kanonische Fragment-URIs: Jede Entität erhält eine persistente
@id(z. B.https://deinedomain.de/#organizationoderhttps://deinedomain.de/#founder). - Explizite Kanten (Relationen): Beziehungen zwischen Objekten werden niemals als flacher Textstring übergeben, sondern als Relationsobjekt:
{ "@id": "https://deinedomain.de/#organization" }.
Mit unserem interaktiven Entitäten Graph Generator kannst du diesen Ontologie-V2-Standard für verschiedenste Branchen-Archetypen (B2B, Handwerk, Praxis, Shop, Freiberufler) mit einem Klick erzeugen.
Der Einfluss auf AI Grounding und den Confidence Score
Generative KIs (RAG-Systeme) sind darauf programmiert, Halluzinationen zu vermeiden. Wenn ein Sprachmodell unstrukturierte Webseitentexte auswertet, muss es Bedeutung erraten. Findet es hingegen eine formal korrekte Ontologie vor, kann es AI Grounding betreiben:
- Die Fakten werden direkt in den internen Wissensgraphen übernommen.
- Der berechnete Confidence Score der Quelle erreicht Maximalwerte.
- Die Wahrscheinlichkeit, dass die Domain in semantischen Suchen und KI-Antworten namentlich als vertrauenswürdige Quelle zitiert wird, steigt dramatisch.
Um die architektonische Gesundheit deines Datenmodells zu überprüfen, nutze den Schema Graph Visualizer. Er deckt fehlerhafte Kanten und Dateninseln auf und vergleicht deine Ist-Ontologie mit dem Soll-Zustand.
Vernetzten Entitäten-Graph Code nach Ontologie V2 erstellen
Erzeuge monolithischen Schema.org JSON-LD Code nach modernsten Ontologie-Standards – ohne isolierte Dateninseln, mit Wikidata sameAs Verankerung.
Die offizielle Agentenbox: Ontologie-Prüfung für KI-Coding-Assistenten
Arbeitsanweisung für deinen KI-Agenten (Cursor / Claude / Antigravity)
Kopiere diesen Prompt direkt in deinen KI-Coding-Assistenten, um das Datenmodell deiner Website auf ontologische Konsistenz und Graph-Integrität zu prüfen:
# Prompt: Semantische Ontologie-Harmonisierung
Rolle: Du bist ein erfahrener Semantic Web Ontologist und Schema-Architekt.
Aufgabe: Analysiere alle vorhandenen Schema.org-Definitionen der Website. Verschmelze getrennte JSON-LD Skripte in eine einheitliche Ontologie V2 unter Nutzung eines gemeinsamen @graph-Arrays mit kanonischen Fragment-URIs.
# Vorgehensweise & Sicherheitsregeln:
1. Tech-Stack-Analyse: Ermittle Webserver, CMS und alle Plugins, die Schema-Markup ausgeben. Identifiziere redundante oder widersprüchliche Entity-Klassen.
2. Defensive Integration: Führe alle Klassen (Organization, WebSite, Person, Service/Product) in einem zentralen Graph zusammen. Überschreibe keine funktionierenden Core-Logiken.
3. Standard- & URL-Hygiene: Verwende eindeutige @id-Fragmente ('https://[deine-domain.de]/#organization'). Stelle sicher, dass Relationen (founder, publisher, author) auf existierende IDs verweisen.
4. Pre-Flight-Validierung: Überprüfe das Markup mit dem W3C RDF Validator und Schema Validator auf Zyklenfreiheit und syntaktische Korrektheit.
Output: 1. Ontologie-Auditbericht, 2. Konsolidierter JSON-LD @graph Code, 3. Anleitung zur Validierung.
Jetzt an der Diskussion teilnehmen
Diskutiere mit Jörg Zimmer und der SEO-Community auf LinkedIn über semantische Ontologien, Knowledge Graphs und die Zukunft des Internets.
Beitrag auf LinkedIn öffnenWas ist eine Ontologie in der Informatik und im SEO?
Was ist der Unterschied zwischen einer Taxonomie und einer Ontologie?
Welche Rolle spielt die Ontologie V2 bei Entitäten-Generatoren?
Warum scheitern klassische SEO-Konzepte ohne ontologisches Verständnis?
Weitere spannende Themen
- Semantische Suche: Vektoren & Entitäten statt Keywords
- Was ist ein Promptset? Aufbau & Strategie
- Share of Model (SoM): Die zentrale KI-Sichtbarkeits-KPI
- SOVP Protocol: Determinismus in KI-Infrastrukturen
- Wenn AI-Agenten deinen LinkedIn-Feed kapern
- Mein geheimer Mega-Prompt für SEO in Claude
- KI-generierte Website Kennzeichnungspflicht?
Nichts mehr verpassen?
Folge mir auf LinkedIn für tägliche SEO-Nuggets und diskutiere mit anderen Experten.
LinkedIn-Profil besuchen →